Cobertura de extremo a extremo Arquitectura, desarrollo, datos, SQL, streaming, Machine Learning, despliegue y operación forman parte de un único programa.
1
Totalmente práctico y aplicable
Formación en Spark a medida
100% bonificable a través de FUNDAE
Curso TUTORIZADO por expertos


Curso de Spark en Aula Virtual Personalizada
Nuestra modalidad AVP es una formación en directo, práctica y 100% adaptada a vuestro equipo. No trabajamos con contenidos genéricos: diseñamos la formación en función de vuestro nivel, objetivos, procesos internos y necesidades reales de aplicación.
Solicitar información
Temario 100% a medida
Creamos el temario desde cero a partir de vuestras necesidades, nivel del equipo y objetivos concretos, priorizando aquellos contenidos que realmente aporten valor en el día a día.
Proyectos personalizados
Durante la formación trabajaremos con archivos, ejemplos, informes o procesos similares a los que utiliza vuestro equipo, para que el aprendizaje sea directamente aplicable al puesto de trabajo.
Sesiones en directo con consultor experto
Un formador especialista imparte las clases en tiempo real, resolviendo dudas, revisando casos concretos y adaptando el ritmo de la formación a la evolución del grupo.
Calendario adaptado a vuestra disponibilidad
Definimos conjuntamente fechas, horarios y duración de las sesiones para facilitar la asistencia del equipo y minimizar el impacto en la operativa diaria de la empresa.
Forma a tu equipo sin costes mediante la bonificación estatal.
Este programa de Spark para empresas es subvencionable hasta el 100%.
Calcula tu bonificación
Revisamos tu caso
Preparamos la gestión
Tu equipo realiza el curso
Aplicas la bonificación
Todos nuestros cursos son bonificables a través de FUNDAE.
Gestionamos toda la documentación por ti.
Calcula tu crédito aproximado
Crédito bonificable estimado
420€*
*Cálculo orientativo
Acelera la adopción de Spark en tu equipo con un curso A Medida en streaming y rendimiento, tutorizado y bonificable por FUNDAE para empresas. Contáctanos.
Diseñamos una formación a medida utilizando los documentos y flujos de trabajo reales de tu empresa.

Los alumnos podrán revisar las sesiones grabadas para repasar conceptos clave, recuperar explicaciones concretas o reforzar aquellos contenidos que necesiten después de la clase en directo.

Materiales, sesiones grabadas y documentación de apoyo quedan centralizados en la plataforma para que el equipo pueda consultarlos durante y después de la formación.

La plataforma permite registrar y confirmar la asistencia de los participantes, facilitando el seguimiento de la formación y la gestión documental necesaria para la bonificación FUNDAE.

Después de la formación en directo, los alumnos podrán acceder a ejercicios prácticos para aplicar lo trabajado en clase y consolidar el aprendizaje con actividades guiadas.
Los alumnos podrán revisar las sesiones grabadas para repasar conceptos clave, recuperar explicaciones concretas o reforzar aquellos contenidos que necesiten después de la clase en directo.
Materiales, sesiones grabadas y documentación de apoyo quedan centralizados en la plataforma para que el equipo pueda consultarlos durante y después de la formación.
La plataforma permite registrar y confirmar la asistencia de los participantes, facilitando el seguimiento de la formación y la gestión documental necesaria para la bonificación FUNDAE.
Después de la formación en directo, los alumnos podrán acceder a ejercicios prácticos para aplicar lo trabajado en clase y consolidar el aprendizaje con actividades guiadas.
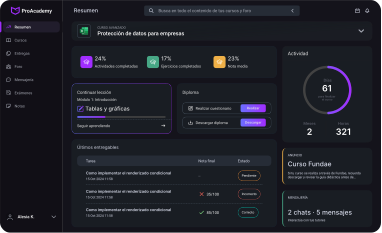
Una plataforma practica, con IA integrada y pensada para que mejores desarrollando. Se adapta a tu ritmo, te corrige al instante y te muestra tu progreso real.
Correccion magica
Feedback inteligente

Aprende de cada acierto y fallo con explicaciones claras
Encuentra todo el temario del curso aquí.

El problema del Big Data: volumen, velocidad, variedad, distribución y límites del procesamiento en una única máquina.
¿Qué es Spark? Motor unificado para procesamiento distribuido de datos batch, streaming, SQL, Machine Learning y otras cargas analíticas.
Usos de Spark en el mundo real: ETL, Data Engineering, analítica, data lakes, procesamiento de eventos, Machine Learning y preparación masiva de datos.
Configurando nuestro IDE: IntelliJ IDEA y alternativas habituales como Visual Studio Code o PyCharm según Scala, Java o PySpark.
¿Qué es Hadoop? Relación actual entre Spark, el ecosistema Hadoop y arquitecturas modernas de datos.
HDFS: arquitectura distribuida, bloques, replicación, NameNode, DataNodes y acceso desde aplicaciones Spark.
Principales comandos de HDFS para navegación, creación de directorios, copia, movimiento, consulta y eliminación de archivos.
Introducción a YARN como gestor de recursos utilizado todavía en plataformas Hadoop.
Instalación de Hadoop o conexión con un entorno existente cuando HDFS o YARN formen parte de la infraestructura.
¿Qué es HBase? Base de datos NoSQL distribuida del ecosistema Hadoop y formas habituales de integrarla con procesos Spark.
Instalación de Spark local y comprobación de Java, Python, variables de entorno y dependencias necesarias.
Arquitectura de Spark: Driver, Executors, Cluster Manager, almacenamiento distribuido y aplicaciones.
Componentes principales: Spark Core, Spark SQL, Structured Streaming, MLlib, GraphX, PySpark y herramientas complementarias.
Ejecutando la consola interactiva de Spark mediante `spark-shell`, `pyspark` y Spark SQL CLI.
Recomendaciones para configurar un entorno reproducible y diferenciar aprendizaje local, desarrollo y ejecución en clúster.
Arquitectura de una aplicación Spark y relación entre Driver, Executors, recursos y datos distribuidos.
Introducción a las APIs de Spark y diferencias entre DataFrames, Datasets, SQL y RDD.
Iniciando Spark desde aplicaciones, notebooks, shells y procesos enviados mediante `spark-submit`.
SparkSession como punto de entrada principal para las APIs estructuradas.
SparkContext y su relación actual con SparkSession y las APIs de bajo nivel.
Introducción a los DataFrames como abstracción principal para datos estructurados y semiestructurados.
Introducción a las particiones como unidad básica de paralelismo y distribución del trabajo.
Introducción a las transformaciones y diferencia entre transformaciones y acciones.
Lazy Evaluation y construcción del plan de ejecución antes de materializar los resultados.
Ejecución de la aplicación y lanzamiento de cálculos cuando una acción requiere obtener un resultado.
Ciclo de vida fuera de las aplicaciones: petición, asignación de recursos, lanzamiento, ejecución y finalización.
Ciclo de vida dentro de las aplicaciones: instrucciones lógicas, dependencias y planificación del trabajo.
Job de Spark como ejecución originada por una acción.
Stages como grupos de tareas separados habitualmente por operaciones de shuffle.
Task como unidad mínima enviada a un executor para procesar una partición.
Transmisión estructurada mediante Structured Streaming para procesamiento incremental y continuo basado en DataFrames.
Diferencias entre Structured Streaming y Spark Streaming basado en DStreams, considerado actualmente una API legacy.
Ejecución de aplicaciones en producción y separación entre desarrollo local, empaquetado y despliegue distribuido.
Datasets como API tipada disponible principalmente para Scala y Java.
APIs de bajo nivel mediante Spark Core y RDD cuando el problema requiere control que no ofrecen las APIs estructuradas.
Spark SQL para procesamiento estructurado mediante SQL y DataFrames sobre un mismo motor.
MLlib mediante la API moderna basada en DataFrames para Machine Learning distribuido.
GraphX para procesamiento de grafos y algoritmos distribuidos.
PySpark como API Python para DataFrames, SQL, Structured Streaming, MLlib y Spark Core.
Pandas API on Spark para determinados workflows procedentes del ecosistema pandas.
Spark Connect como arquitectura cliente-servidor para trabajar con Spark desde aplicaciones desacopladas del Driver.
Spark Declarative Pipelines como framework actual para definir pipelines batch y streaming de forma declarativa.
Ecosistema y paquetes de Spark para integrar conectores, fuentes, formatos y tecnologías externas.
SparkR y procesamiento con R como funcionalidad heredada actualmente deprecada.
Criterios para elegir una API sin utilizar RDD, Dataset o cualquier otra abstracción por costumbre.
DataFrames y su representación de datos distribuidos mediante columnas y esquema.
DataSets y tipado en Scala y Java.
DataFrames vs DataSets y criterios para seleccionar cada abstracción.
Relación entre `DataFrame` y `Dataset[Row]` dentro de la API JVM.
Esquemas inferidos frente a esquemas definidos explícitamente.
`StructType`, `StructField` y representación programática de esquemas.
Columnas y filas como elementos fundamentales de los datos estructurados.
Tipos en Spark y correspondencia con tipos SQL, Python, Java y Scala.
Transformaciones estructuradas frente a operaciones basadas en objetos de lenguaje.
Planificación lógica de una consulta o cadena de transformaciones.
Resolución del esquema y de las expresiones antes de ejecutar la consulta.
Planificación física y selección de operadores para materializar el resultado.
Ejecución distribuida de consultas DataFrame y SQL sobre el mismo motor.
Ventajas de proporcionar a Spark información estructural sobre los datos.
Elección entre DataFrame, Dataset, SQL y RDD según lenguaje, problema y necesidad de optimización.
Operaciones sobre esquemas e inspección de columnas y tipos.
Columnas y expresiones mediante la API de funciones de Spark.
Creación de filas y construcción de estructuras compatibles con un esquema.
Creación de DataFrames desde colecciones, RDD, archivos, tablas y fuentes externas.
Selección con `select` y `selectExpr`.
Uso de `expr` para combinar expresiones SQL con la API DataFrame.
Conversión de tipos y tratamiento de incompatibilidades.
Añadir columnas mediante `withColumn` y operaciones equivalentes.
Renombrado de columnas.
Casteo del tipo de las columnas mediante `cast`.
Obtención de filas con `show`, `take`, `head` y otras acciones.
Filtrado de filas mediante `filter` y `where`.
Muestreo aleatorio mediante `sample`.
Divisiones aleatorias mediante `randomSplit`.
Uniones de filas mediante `union` y `unionByName`.
Eliminación de duplicados mediante `distinct` y `dropDuplicates`.
Aplicación de límites mediante `limit`.
Ordenación de filas con `sort` y `orderBy`.
Repartición mediante `repartition` y reducción de particiones con `coalesce`.
Riesgos de utilizar `collect` o conversiones locales sobre datasets demasiado grandes para el Driver.
Conversión a tipos de Spark y definición explícita de tipos cuando la inferencia no es suficiente.
Trabajando con números enteros, decimales y tipos de precisión fija.
Trabajando con cadenas de texto y funciones integradas de manipulación.
Trabajando con expresiones regulares.
Trabajando con fechas y horas.
Diferencia entre fechas, timestamps y representación temporal.
Trabajando con booleanos y expresiones condicionales.
Trabajando con datos nulos y semántica SQL de `NULL`.
Uso de `coalesce`, `fill`, `drop` y otras estrategias para valores ausentes.
Trabajando con arrays, maps, estructuras y otros datos complejos.
Higher-order functions para transformar arrays y maps mediante expresiones nativas.
Trabajando con JSON y estructuras anidadas.
Uso del tipo `VARIANT` para determinados datos semiestructurados en las versiones modernas de Spark.
Ordenación de datos y gestión explícita de valores nulos durante la ordenación.
Uso de funciones definidas por el usuario cuando las funciones integradas no permiten expresar la transformación.
Diferencias entre UDF Python, Pandas UDF y funciones nativas desde la perspectiva de rendimiento.
Funciones de agregación disponibles en Spark.
`count`, `sum`, `avg`, `min`, `max`, `first`, `last` y funciones estadísticas habituales.
Agrupaciones con expresiones mediante `groupBy`.
Agrupaciones con maps y expresiones dinámicas.
Agrupación de sets mediante grouping sets, `rollup` y `cube`.
Agregaciones sobre varias columnas y múltiples métricas.
Funciones ventana para cálculos sobre filas relacionadas.
`row_number`, `rank`, `dense_rank`, `lag` y `lead`.
Uso de funciones de agregación definidas por el usuario cuando resulta necesario.
Expresiones de unión y construcción de condiciones entre DataFrames.
Tipos de Joins: inner, left, right, full, cross, left semi y left anti.
Equi-joins frente a condiciones de unión más complejas.
¿Cómo realiza Spark los joins? Introducción a estrategias de ejecución físicas.
Broadcast Join como estrategia útil cuando una de las relaciones es suficientemente pequeña.
Shuffle y redistribución de datos provocados por determinados joins y agregaciones.
Data skew y consecuencias de distribuir de manera desigual las claves.
Adaptive Query Execution como mecanismo actual que permite reajustar determinados aspectos de una consulta durante su ejecución.
Lectura inicial de un plan físico para reconocer joins y exchanges.
Las bases de la API de lectura de datos mediante `DataFrameReader`.
Las bases de la API de escritura de datos mediante `DataFrameWriter`.
Lectura y escritura de archivos CSV.
Lectura y escritura de archivos JSON.
Lectura y escritura de archivos Parquet como formato columnar de referencia en numerosas arquitecturas analíticas.
Lectura y escritura de archivos ORC.
Lectura y escritura de Avro cuando el formato y el conector forman parte de la solución.
Lectura y escritura de archivos TXT.
Lectura y escritura de bases de datos SQL mediante JDBC.
Paralelización de lecturas JDBC y precauciones sobre carga en el sistema origen.
Lectura desde HDFS.
Lectura y escritura sobre almacenamiento de objetos como S3, Azure Data Lake Storage o Google Cloud Storage mediante la configuración correspondiente.
Definición explícita del esquema frente a inferencia automática.
Modos de escritura `append`, `overwrite`, `ignore` y error.
Particionado de archivos al escribir datasets.
Predicate pushdown y column pruning como mecanismos para reducir datos leídos cuando el formato y la fuente lo permiten.
Problema de los archivos pequeños y consecuencias sobre planificación e I/O.
Introducción a formatos de tabla como Iceberg, Delta Lake o Hudi como tecnologías complementarias a Spark, sin profundizar todavía en su arquitectura.
Introducción a Spark SQL como módulo para datos estructurados.
Relación entre Spark SQL y DataFrames.
Introducción a Apache Hive y relación con Spark.
Integración con Hive Metastore cuando forma parte de la arquitectura existente.
Introducción a Spark SQL CLI.
Introducción a la interfaz programática de SQL de Spark mediante `spark.sql`.
Operaciones SQL y combinación de SQL con transformaciones DataFrame.
Opciones de Entrada/Salida.
Catálogo y resolución de tablas, vistas y namespaces.
Introducción de las tablas de Spark SQL.
Creación de tablas.
Creación de tablas externas.
Diferencia conceptual entre tablas gestionadas y externas.
Inserción de datos en tablas mediante `INSERT INTO` e `INSERT OVERWRITE`.
`CREATE TABLE AS SELECT`.
Metadatos de tablas y uso de `DESCRIBE`.
Borrado de tablas.
Cacheado de tablas.
Introducción a las vistas de Spark SQL.
Creación de vistas temporales y globales.
Borrado de vistas.
Introducción a las bases de datos y namespaces de Spark SQL.
Creación, selección y borrado de bases de datos.
Selects con `CASE`, `WHEN` y `THEN`.
Funciones escalares, agregadas y de ventana.
Tipos complejos y estructuras anidadas.
Subqueries.
Common Table Expressions mediante `WITH`.
Configuraciones generales.
Establecimiento de valores de configuración en SQL mediante `SET`.
Introducción a ANSI SQL y comportamiento estricto ante determinadas operaciones inválidas.
Introducción a SQL Scripting actual para flujos SQL con variables y control de ejecución, dejando sus capacidades avanzadas para niveles posteriores.
¿Cuándo debemos usar Datasets?
Diferencias entre Dataset tipado y DataFrame.
Disponibilidad principalmente en Scala y Java.
Creación de DataSets desde colecciones JVM.
Encoders y conversión entre objetos JVM y representación interna de Spark.
Creación de DataSets a partir de DataFrames.
Acciones.
Transformaciones, filtrado y mapeo.
Operaciones tipadas frente a expresiones DataFrame.
Joins de DataSets.
Agrupaciones y agregaciones.
Conversión entre Dataset y DataFrame.
Ventajas del tipado durante compilación.
Limitaciones y coste de utilizar transformaciones basadas en objetos frente a expresiones estructuradas.
Criterios para decidir entre DataFrame y Dataset en nuevos desarrollos.
Introducción a los RDD en Spark.
Qué significa Resilient Distributed Dataset.
Tipos de RDDs y relación con las fuentes que los originan.
¿Cuándo es conveniente usar RDDs?
Ventajas de DataFrames vs RDD.
Limitaciones de los RDD al no proporcionar al optimizador el mismo conocimiento estructural.
Creación de un RDD.
Interoperabilidad entre RDDs, DataSets y DataFrames.
Creación de un RDD a partir de una colección local.
Creación de un RDD desde distintos orígenes.
Manipulación de RDDs.
Transformaciones como `map`, `flatMap` y `filter`.
Acciones como `count`, `take`, `reduce` y `collect`.
Guardado en archivos de texto.
Guardado en archivos Hadoop.
Otros tipos de guardado mediante APIs y conectores compatibles.
Cacheo y persistencia de RDDs.
Storage Levels.
Establecimiento de puntos de control mediante checkpoint.
Lineage y recuperación ante pérdida de particiones.
RDDs numéricos y operaciones estadísticas básicas.
Riesgos de enviar grandes cantidades de información al Driver.
Introducción a los RDD Clave-Valor en Spark.
Creación de RDD Clave-Valor.
Introducción a las bases del uso de Clave-Valor.
Transformación `filter`.
`mapValues`.
`flatMapValues`.
`reduceByKey`.
`aggregateByKey`.
`combineByKey`.
`groupByKey`.
Diferencias de tráfico y agregación entre `reduceByKey` y `groupByKey`.
`sortByKey`.
CoGrupos.
Control de particionamiento de datos.
HashPartitioner y particionadores personalizados.
Preservación del particionamiento entre determinadas transformaciones.
Operaciones Join.
Shuffles provocados por operaciones Clave-Valor.
Serialización personalizada.
Casos donde un DataFrame agregado proporciona una solución más optimizable que un Pair RDD.
Introducción a GraphX y al procesamiento distribuido de grafos.
Conceptos de vértice, arista, propiedades y grafo dirigido.
Operadores GraphX.
Usos reales de GraphX.
Configuración y puesta en marcha.
Construcción de grafos desde colecciones y RDD.
Algoritmos de GraphX.
PageRank.
Connected Components.
Triangle Count.
Pregel API para procesamiento iterativo de grafos.
GraphX builders.
VertexRDD.
EdgeRDD.
Transformación y filtrado de grafos.
Agregación de mensajes entre vértices.
Subgrafos y operaciones estructurales.
Integración de resultados de GraphX con otras APIs de Spark.
Buenas prácticas y criterios para valorar librerías de grafos externas cuando GraphX no cubre el caso de uso.
Por qué no se comparten variables locales de forma convencional entre Driver y Executors.
Serialización de closures y variables utilizadas dentro de funciones distribuidas.
Transmisión de variables mediante Broadcast Variables.
Casos de uso apropiados para variables broadcast.
Distribución eficiente de información de solo lectura a los executors.
Diferencias entre una Broadcast Variable y un Broadcast Join.
Liberación de recursos asociados a variables broadcast.
Acumuladores.
Acumuladores numéricos.
Uso de acumuladores para métricas y contadores distribuidos.
Limitaciones de los acumuladores dentro de transformaciones reejecutables.
Accumulators en tareas que pueden volver a ejecutarse.
Acumuladores personalizados.
Visibilidad de acumuladores desde herramientas de monitorización cuando corresponda.
Buenas prácticas para evitar utilizar variables compartidas como sustituto de un diseño distribuido correcto.
Modos de ejecución y diferencias entre local y cluster.
Introducción al ciclo de vida de una aplicación Spark desde fuera.
Fase de petición de cliente.
Comunicación con el Cluster Manager.
Fases de iniciación y asignación de recursos.
Creación del Driver.
Creación de Executors.
Envío del código de la aplicación a los executors.
Fase de ejecución.
Fase de terminación y liberación de recursos.
Introducción al ciclo de vida de una aplicación Spark desde dentro de Spark.
La sesión de Spark.
Las instrucciones lógicas y Lazy Evaluation.
El Job de Spark.
Las fases o Stages.
Las Tasks.
Particiones y correspondencia habitual con Tasks.
Shuffles como fronteras habituales entre Stages.
Detalles de ejecución visibles desde Spark UI.
Diferencias entre Driver y Executor failures.
Introducción a Dynamic Resource Allocation sin entrar todavía en tuning avanzado.
Estructura de los proyectos.
Estructura de proyectos PySpark.
Maven y SBT en proyectos Scala o Java.
¿Dónde se pueden desplegar las aplicaciones de Spark?
`spark-submit`.
Parámetros principales de `spark-submit`.
Empaquetado de aplicaciones.
Distribución de dependencias Python y JVM.
On-premise Clusters vs Cloud.
Introducción a los cluster managers.
Modo Standalone.
Spark con YARN.
Configuración de Spark con aplicaciones YARN.
Spark sobre Kubernetes.
Diferencias generales entre YARN y Kubernetes.
Eliminación de Apache Mesos del planteamiento actual al no formar parte de los cluster managers documentados para Spark moderno.
Client Mode frente a Cluster Mode.
Configuraciones para desarrollo seguro.
Configuraciones para redes de clusters.
Autenticación, autorización y cifrado a nivel introductorio.
Estrategias de replicación asociadas al almacenamiento y no al motor Spark en sí.
Creación o aprovisionamiento de un cluster.
Lanzamiento de trabajos.
Monitorización de clusters.
Particionamiento y distribución del trabajo.
Buenas prácticas de despliegue y externalización de configuración.
Monitorización de Spark jobs.
Interfaz Web de Spark.
Acceso a la UI del Driver durante la ejecución.
Jobs.
Stages.
Tasks y distribución de tiempos de ejecución.
Executors.
Storage.
SQL.
Structured Streaming.
Environment y comprobación de configuración efectiva.
Visualizando aplicaciones de Spark con interfaces web.
DAG Visualization.
Análisis de tareas fallidas.
Shuffle Read y Shuffle Write.
Input y Output metrics.
Los logs en las aplicaciones de Spark.
Log4j2 en Spark.
Event Logs.
Spark History Server para consultar aplicaciones finalizadas.
Introducción a los sistemas de métricas de Spark y su integración con herramientas externas.
Diferencia entre observar la aplicación Spark y observar también la infraestructura subyacente.
Técnicas de optimización y necesidad de medir antes de modificar configuraciones.
Uso y gestión de la memoria.
Almacenamiento de datos en caché de memoria.
Cuándo utilizar `cache` y `persist`.
Eliminación del cache mediante `unpersist`.
Selección adecuada del número de particiones.
Evitar particiones excesivamente pequeñas o excesivamente grandes.
Reducción de datos lo antes posible mediante filtros y selección de columnas.
Predicate pushdown y column pruning.
Sugerencias combinadas para consultas SQL.
Broadcast de tablas pequeñas en joins adecuados.
Evitar UDF cuando una función nativa permite expresar la misma lógica.
Adaptive Query Execution.
Coalescing adaptativo de particiones después de un shuffle.
Tratamiento automático básico de skew.
Ejecución de consultas adaptables.
Formatos columnares como Parquet y ORC para cargas analíticas.
Efecto del tamaño y número de archivos sobre planificación y lectura.
Uso razonado de `repartition` y `coalesce`.
Interpretación inicial de `explain` antes de realizar cambios de rendimiento.
Entorno distribuido y diferencias respecto a depurar una aplicación local convencional.
Pruebas en un entorno distribuido.
Problemas característicos de un entorno distribuido.
Separación de lógica pura y lógica dependiente de Spark para facilitar el testing.
Testing en aplicaciones Spark.
Tipos de test.
Tests unitarios sobre funciones y transformaciones.
Tests de integración mediante SparkSession local.
Creación de DataFrames pequeños y deterministas para pruebas.
Comparación de esquemas.
Comparación de resultados.
Testing de lectura y escritura.
Testing de pipelines de datos.
Testing básico de Structured Streaming.
Métodos de test en Spark.
Debugging en aplicaciones Spark.
Diferencia entre errores producidos en Driver y Executors.
Stack traces distribuidos.
Errores de serialización.
Errores de memoria.
Errores derivados de datos problemáticos.
Uso de logs, Spark UI y planes de ejecución durante el diagnóstico.
Reproducibilidad de fallos antes de modificar la aplicación.
Introducción a MLlib.
Diferencia entre la API moderna `spark.ml` basada en DataFrames y las APIs RDD de `spark.mllib` en modo mantenimiento.
Fundamentos de MLlib.
Features y labels.
Transformers.
Estimators.
Models.
Pipelines.
Preparación de características con VectorAssembler y otros transformers.
Entrenamiento y evaluación.
Persistencia y aplicación de modelos.
Creación de un sistema de Machine Learning con MLlib.
Regresión Lineal con MLlib.
Regresión logística.
Árboles de decisión.
Bosques aleatorios.
Gradient-Boosted Trees.
Clustering mediante algoritmos disponibles en MLlib.
DataFrames con MLlib.
Métricas para clasificación y regresión.
Evaluators.
TrainValidationSplit y CrossValidator a nivel introductorio.
Guardado y carga de Pipelines y Models.
Criterios para decidir si Spark es necesario para el volumen del problema de Machine Learning.
Planes de ejecución.
Uso de `explain` para comprender cómo Spark pretende resolver una consulta.
Diferencia entre plan lógico y plan físico a nivel introductorio.
Detectando un Shuffle en un procesamiento.
Operadores `Exchange` como señal de redistribución de datos.
Probando operaciones que puedan causar un Shuffle.
Joins como fuente habitual de shuffle.
Agrupaciones y agregaciones como fuente habitual de shuffle.
Repartición y ordenaciones globales.
Cambiando el diseño de trabajos con dependencias amplias.
Uso de agregaciones parciales para reducir movimiento de datos.
Usando operaciones keyBy o estructuras clave-valor cuando el problema realmente lo requiere.
Usando particionadores personalizados en RDD.
Detectando Data Skew.
Tasks significativamente más lentas que el resto.
Particiones desequilibradas.
Detectando problemas de memoria.
Detectando spills a disco.
Detectando problemas de serialización.
Fetch failures y errores relacionados con shuffle.
Detección de exceso de archivos pequeños.
Diferenciación entre problema de aplicación, datos, configuración, almacenamiento e infraestructura.
Serialización de objetos en RDD.
Java Serialization frente a Kryo en aplicaciones JVM cuando resulte apropiado.
Configuraciones de Clusters.
Elección de diseño.
Programación y utilización preferente de funciones optimizables.
Shuffle de configuraciones.
Número de particiones de shuffle.
Recolector de basura.
Gestión de la memoria.
Memoria del Driver.
Memoria de los Executors.
Memory Overhead.
Paralelismo.
Número de cores por executor.
Tamaño de las particiones.
Mejoras en el filtrado.
Repartición.
Uso de `coalesce`.
Funciones definidas por el usuario.
Funciones integradas frente a UDF.
Cacheo de datos de forma temporal.
Uniones.
Agregaciones.
Transmisión de variables.
Broadcast Join frente a Broadcast Variable.
Configuración de recursos según características de CPU, memoria, red e I/O.
Evitar tuning prematuro sin analizar Spark UI, métricas y planes.
Introducción a la relación entre coste, rendimiento y recursos utilizados.
Recomendaciones de programación paralela.
Diseñar transformaciones pensando en datos distribuidos y no como si se tratara de colecciones locales.
Inmutabilidad.
Uso de lambdas.
Evitar closures excesivamente grandes.
Bucles y criterios para sustituir procesamiento local por operaciones distribuidas.
Uso de funciones dentro de DataFrames.
Priorizar funciones nativas de Spark SQL cuando exista una equivalente adecuada.
Evitar `collect` salvo cuando el volumen que llega al Driver está controlado.
Evitar conversiones innecesarias entre RDD y DataFrame.
Gestionar correctamente particiones, persistencia y recursos.
Especificaciones y diferencias de PySpark.
Python 3.10+ en las distribuciones actuales de PySpark.
Integración con pandas mediante Apache Arrow.
Pandas API on Spark y diferencias frente a pandas local.
Cuándo utilizar PySpark frente a pandas.
Especificaciones de Scala y uso de Scala 2.13 en Spark 4.
Particularidades de Java dentro de las APIs Spark.
Datasets tipados en Scala y Java.
Spark Connect como alternativa moderna para determinadas aplicaciones cliente.
Especificaciones y diferencias de R con Spark.
SparkR como tecnología deprecada que debe evitarse como elección principal para nuevos proyectos.
Gestión de dependencias y versiones según Python, Scala o Java.
Configuración externalizada frente a parámetros hardcoded.
Código reproducible, modular y preparado para pasar posteriormente a pruebas, despliegue y operación.
Introducción a Spark Declarative Pipelines como evolución actual para determinados pipelines batch y streaming, dejando su arquitectura profunda para la formación avanzada.
Criterios finales para seleccionar DataFrame, Dataset, SQL o RDD sin perder las capacidades de optimización del motor.
Data Engineers
Profesionales responsables de ingestión, transformación, procesamiento y preparación de grandes volúmenes de datos.
Big Data Developers
Desarrolladores que necesitan construir aplicaciones distribuidas mediante PySpark, Scala o Java.
Data Architects
Profesionales encargados de decidir formatos, procesamiento, almacenamiento, streaming y arquitectura de plataformas analíticas.
Backend Developers
Perfiles que quieren evolucionar hacia procesamiento distribuido y servicios intensivos en datos.
Analytics Engineers
Profesionales que necesitan combinar SQL, transformaciones y modelos analíticos sobre datasets de gran escala.
Machine Learning Engineers
Perfiles que utilizan Spark para preparación distribuida de datos y pipelines de MLlib.
Platform Engineers
Profesionales responsables de Kubernetes, YARN, infraestructura, seguridad y operación de cargas Spark.
DevOps Engineers
Perfiles encargados de automatizar deployments, configuración, monitorización y observabilidad de aplicaciones Spark.
Data Analysts con perfil técnico
Usuarios avanzados de SQL o Python que necesitan trabajar con datasets que superan las capacidades de procesamiento local.
Arquitectos Cloud
Profesionales que diseñan plataformas Spark sobre almacenamiento y servicios de infraestructura cloud.
Administradores Big Data
Perfiles responsables de clústeres, recursos, disponibilidad, seguridad y rendimiento.
Experiencias reales de equipos que ya han trabajado con nosotros.
+16
años de liderazgo
+3.500
empresas formadas
Nuestra empresa decidió contratar formación con Imagina aprovechando los créditos de FUNDAE, y fue una gran decisión. La modalidad online nos permitió adaptar los horarios a nuestro equipo. La formación ha sido práctica, clara y útil para el día a día. Es sencillo de gestionar y los resultados son excepcionales.

Hugo Gutiérrez
Analista Financiero
Gracias a Imagina, la eficiencia de nuestras sesiones de capacitación ha mejorado drásticamente. Es sencillo de usar y los resultados son excepcionales.
Luis Martínez
Administrativo
Gracias al aula virtual de Imagina siempre son capaces de adaptar los cursos a nuestras necesidades. El contenido fue muy completo y práctico.
Elena Pérez
Responsable de Recursos Humanos
Mejor de lo esperado, la modalidad online se adapta a nuestros horarios. La ayuda con la bonificación FUNDAE hizo todo más fácil. Práctico y necesario.
Alejandro Sánchez
Director de Operaciones
Nuestra empresa decidió contratar formación con Imagina aprovechando los créditos de FUNDAE, y fue una gran decisión. La modalidad online nos permitió adaptar los horarios a nuestro equipo. La formación ha sido práctica, clara y útil para el día a día. Es sencillo de gestionar y los resultados son excepcionales.
Hugo Gutiérrez
Analista Financiero
Gracias a Imagina, la eficiencia de nuestras sesiones de capacitación ha mejorado drásticamente. Es sencillo de usar y los resultados son excepcionales.
Luis Martínez
Administrativo
Gracias al aula virtual de Imagina siempre son capaces de adaptar los cursos a nuestras necesidades. El contenido fue muy completo y práctico.
Elena Pérez
Responsable de Recursos Humanos
Mejor de lo esperado, la modalidad online se adapta a nuestros horarios. La ayuda con la bonificación FUNDAE hizo todo más fácil. Práctico y necesario.
Alejandro Sánchez
Director de Operaciones
480.000 alumnos formados en Imagina
Explora las respuestas a las preguntas que guian a nuestra comunidad. Aqui encontraras claridad sobre como funciona todo, desde el acceso hasta los detalles de los cursos. Si buscas respuestas, este es el lugar para comenzar.
El contenido se ha diseñado sobre la rama estable actual de Apache Spark 4.2, manteniendo referencias a versiones anteriores solo cuando ayudan a comprender migraciones o sistemas existentes.
Se explican ambos ecosistemas y Java cuando aporta valor, aunque PySpark puede utilizarse como lenguaje principal si el grupo necesita una única implementación de referencia.
Sí. Se cubren RDD y Pair RDD para comprender Spark Core y escenarios de bajo nivel, pero Spark recomienda DataFrames para la mayoría de nuevas cargas estructuradas.
Sí. Se explican HDFS y YARN y su relación con Spark, pero no se presenta Hadoop como requisito obligatorio para utilizar Spark.
Se explica su posición histórica, pero el desarrollo se centra en Structured Streaming. Spark identifica actualmente DStreams como tecnología legacy sin evolución funcional.
Sí. El curso profundiza en DataFrames, tablas, vistas, catálogos, funciones, subqueries, Window Functions y SQL Scripting.
Sí. Incluye `transformWithState`, state variables, timers, TTL, event time, watermarks y checkpoints.
Sí. Spark Declarative Pipelines permite definir en Python o SQL pipelines con streaming tables, materialized views y dependencias gestionadas por Spark.
Sí. Kubernetes forma parte de los cluster managers actuales junto a Spark Standalone y Hadoop YARN.
La formación puede ser bonificable a través de FUNDAE hasta el 100% cuando la empresa dispone de crédito suficiente y se cumplen los requisitos aplicables a la Formación Programada por las Empresas.
¿Tienes dudas?
Estamos aqui para ayudarte
El contenido se ha diseñado sobre la rama estable actual de Apache Spark 4.2, manteniendo referencias a versiones anteriores solo cuando ayudan a comprender migraciones o sistemas existentes.
¿Tienes dudas?
Estamos aqui para ayudarte
Se explican ambos ecosistemas y Java cuando aporta valor, aunque PySpark puede utilizarse como lenguaje principal si el grupo necesita una única implementación de referencia.
¿Tienes dudas?
Estamos aqui para ayudarte
Sí. Se cubren RDD y Pair RDD para comprender Spark Core y escenarios de bajo nivel, pero Spark recomienda DataFrames para la mayoría de nuevas cargas estructuradas.
¿Tienes dudas?
Estamos aqui para ayudarte
Sí. Se explican HDFS y YARN y su relación con Spark, pero no se presenta Hadoop como requisito obligatorio para utilizar Spark.
¿Tienes dudas?
Estamos aqui para ayudarte
Se explica su posición histórica, pero el desarrollo se centra en Structured Streaming. Spark identifica actualmente DStreams como tecnología legacy sin evolución funcional.
¿Tienes dudas?
Estamos aqui para ayudarte
Sí. El curso profundiza en DataFrames, tablas, vistas, catálogos, funciones, subqueries, Window Functions y SQL Scripting.
¿Tienes dudas?
Estamos aqui para ayudarte
Sí. Incluye `transformWithState`, state variables, timers, TTL, event time, watermarks y checkpoints.
¿Tienes dudas?
Estamos aqui para ayudarte
Sí. Spark Declarative Pipelines permite definir en Python o SQL pipelines con streaming tables, materialized views y dependencias gestionadas por Spark.
¿Tienes dudas?
Estamos aqui para ayudarte
Sí. Kubernetes forma parte de los cluster managers actuales junto a Spark Standalone y Hadoop YARN.
¿Tienes dudas?
Estamos aqui para ayudarte
La formación puede ser bonificable a través de FUNDAE hasta el 100% cuando la empresa dispone de crédito suficiente y se cumplen los requisitos aplicables a la Formación Programada por las Empresas.
¿Tienes dudas?
Estamos aqui para ayudarte
Descubre Que es Microsoft Power Automate o Microsoft Flow: Guía Completa de la Herramienta de Automatización de Tareas de Microsoft
Descubre cómo instalar Kali Linux fácilmente y empieza a usar esta herramienta esencial para pruebas de penetración y análisis forense digital.
Conoce los cursos bonificados para trabajadores 2025 más demandados y cómo puedes inscribir a tus empleados para aprovechar los créditos formativos de FUNDAE.
Conoce los cursos obligatorios para empresas 2025 y cómo asegurar que tu organización cumpla con las normativas actuales sin riesgos de sanciones.
Descubre los mejores cursos bonificados para empresas en 2025 por la Fundación Tripartita. Aumenta la productividad de tu equipo sin costes adicionales.
"/>
<path d="M324.205 820C423.825 820 417.609 776.747 417.609 776.747L417.497 731.939H322.428V718.488H455.251C455.251 718.488 519 725.727 519 625.084C519 524.44 463.361 528.016 463.361 528.016H430.152V574.715C430.152 574.715 431.947 630.42 375.405 630.42H281.115C281.115 630.42 228.144 629.563 228.144 681.681V767.841C228.144 767.841 220.099 819.988 324.205 819.988V820ZM376.624 789.869C374.381 789.872 372.158 789.431 370.085 788.574C368.011 787.716 366.126 786.457 364.538 784.87C362.95 783.283 361.69 781.398 360.83 779.324C359.97 777.249 359.526 775.025 359.525 772.778V772.778C359.522 770.532 359.962 768.306 360.819 766.23C361.675 764.153 362.932 762.266 364.517 760.676C366.102 759.085 367.985 757.823 370.057 756.961C372.129 756.099 374.351 755.654 376.595 755.652V755.652C378.84 755.644 381.065 756.08 383.142 756.933C385.22 757.786 387.109 759.041 388.702 760.625C390.294 762.21 391.56 764.093 392.426 766.167C393.292 768.241 393.741 770.466 393.748 772.714V772.743C393.751 777.281 391.954 781.635 388.751 784.846C385.549 788.058 381.204 789.865 376.671 789.869H376.624Z" fill="url(%23paint1_linear)"/>
<path d="M517.545 434.125C516.649 432.292 516.277 431.369 515.808 430.446C503.222 406.549 490.69 382.693 477.993 358.782C477.36 357.896 477.075 356.809 477.192 355.726C477.308 354.644 477.819 353.642 478.627 352.911C498.608 329.593 518.533 306.197 538.404 282.723C539.218 281.846 539.768 280.757 539.989 279.581L522.522 284.142C498.341 290.574 474.202 297.005 450.104 303.436C447.843 304.015 446.85 303.436 445.692 301.493C431.961 278.588 418.207 255.716 404.431 232.876C403.716 231.532 402.69 230.38 401.439 229.513C400.336 235.604 399.178 241.737 398.13 247.815L386.647 312.449C386.233 314.751 385.654 317.121 385.447 319.423C385.24 321.724 384.069 322.468 382.083 323.089C353.592 332 325.152 340.981 296.761 350.031C295.352 350.446 294.05 351.161 292.943 352.126C316.227 361.359 339.457 370.634 363.1 380.019C362.448 380.595 361.767 381.138 361.06 381.646C346.529 391.026 331.985 400.443 317.427 409.898C316.716 410.462 315.853 410.804 314.948 410.88C314.043 410.956 313.135 410.763 312.34 410.325C294.983 402.511 277.516 394.862 260.118 387.048C252.276 383.791 245.317 378.724 239.811 372.261C227.404 357.101 229.913 339.916 246.373 329.428C251.89 326.032 257.808 323.338 263.992 321.407C291.895 312.339 319.839 303.588 347.797 294.782C348.824 294.586 349.759 294.06 350.459 293.284C351.158 292.507 351.584 291.523 351.671 290.482C355.394 268.941 359.281 247.387 363.155 225.847C365.251 214.312 366.353 202.515 371.964 191.986C374.088 187.87 376.714 184.032 379.781 180.561C390.893 168.241 406.361 167.758 418.106 179.514C422.064 183.565 425.534 188.066 428.446 192.923C441.391 213.995 454.088 235.232 466.771 256.469C468.246 258.977 469.611 259.501 472.382 258.716C503.631 250.373 534.833 242.104 565.99 233.909C572.35 232.106 579.029 231.73 585.552 232.807C599.917 235.48 606.231 246.436 601.392 260.369C599.024 266.544 595.517 272.22 591.053 277.1C569.298 302.733 547.502 328.33 525.665 353.89C524.856 354.634 524.35 355.649 524.243 356.742C524.137 357.836 524.437 358.93 525.086 359.816C538.142 384.402 551.045 408.988 564.004 433.629C567.092 439.5 569.45 445.633 569.519 452.399C569.552 459.779 566.891 466.916 562.036 472.475C557.181 478.034 550.465 481.632 543.146 482.594C534.599 483.848 526.603 482.016 518.593 479.549C499.044 473.522 479.468 467.55 459.864 461.633C459.092 461.519 458.384 461.136 457.867 460.551C457.349 459.965 457.056 459.216 457.038 458.436C454.777 444.654 452.31 430.873 449.952 417.091C449.948 416.547 449.985 416.004 450.063 415.465C472.341 421.653 494.481 427.744 517.504 434.139" fill="%23E15C22"/>
<path fill-rule="evenodd" clip-rule="evenodd" d="M696.1 167.2V114H739.8V167.2L793 167.2V210.9H739.8V266H696.1V210.9L641 211.139V167.2H696.1Z" fill="%232C2656"/>
<defs>
<linearGradient id="paint0_linear" x1="165.249" y1="467.673" x2="361.119" y2="662.871" gradientUnits="userSpaceOnUse">
<stop stop-color="%23387EB9"/>
<stop offset="1" stop-color="%23366994"/>
</linearGradient>
<linearGradient id="paint1_linear" x1="283.798" y1="596.292" x2="490.508" y2="791.454" gradientUnits="userSpaceOnUse">
<stop stop-color="%23FFDF44"/>
<stop offset="1" stop-color="%23FFC219"/>
</linearGradient>
</defs>
</svg>)
Aumente su conocimiento en Apache Spark con conceptos avanzados.
"/>
<path d="M411.727 843C529.491 843 522.142 791.896 522.142 791.896L522.011 738.955H409.626V723.063H566.64C566.64 723.063 642 731.616 642 612.705C642 493.794 576.227 498.019 576.227 498.019H536.97V553.194C536.97 553.194 539.092 619.01 472.252 619.01H360.789C360.789 619.01 298.17 617.998 298.17 679.576V781.373C298.17 781.373 288.659 842.986 411.727 842.986V843ZM473.693 807.4C471.041 807.403 468.414 806.883 465.963 805.869C463.511 804.856 461.283 803.369 459.406 801.494C457.529 799.619 456.039 797.392 455.022 794.941C454.005 792.489 453.481 789.861 453.479 787.207C453.476 784.553 453.996 781.924 455.009 779.47C456.022 777.017 457.507 774.787 459.381 772.908C461.255 771.029 463.48 769.538 465.93 768.519C468.38 767.501 471.006 766.975 473.659 766.973C476.313 766.963 478.943 767.478 481.399 768.486C483.854 769.494 486.087 770.977 487.97 772.848C489.853 774.72 491.349 776.945 492.373 779.396C493.396 781.846 493.927 784.475 493.935 787.131V787.166C493.939 792.527 491.815 797.671 488.029 801.465C484.244 805.26 479.107 807.395 473.749 807.4H473.693Z" fill="url(%23paint1_linear)"/>
<path d="M640.113 388.196C639.055 386.028 638.615 384.936 638.062 383.844C623.202 355.582 608.408 327.368 593.418 299.089C592.67 298.041 592.333 296.754 592.471 295.474C592.609 294.194 593.213 293.009 594.166 292.145C617.755 264.567 641.279 236.897 664.738 209.134C665.7 208.097 666.348 206.808 666.61 205.417L645.988 210.812C617.441 218.419 588.942 226.025 560.492 233.631C557.823 234.316 556.651 233.631 555.284 231.333C539.073 204.244 522.835 177.193 506.57 150.18C505.726 148.591 504.515 147.228 503.039 146.203C501.736 153.407 500.369 160.66 499.132 167.848L485.575 244.291C485.086 247.013 484.403 249.816 484.159 252.538C483.915 255.26 482.531 256.14 480.187 256.874C446.551 267.414 412.974 278.036 379.457 288.739C377.793 289.229 376.255 290.075 374.948 291.216C402.438 302.137 429.863 313.106 457.776 324.206C457.005 324.887 456.202 325.529 455.367 326.129C438.212 337.223 421.041 348.361 403.854 359.542C403.015 360.21 401.996 360.615 400.928 360.705C399.859 360.795 398.788 360.566 397.848 360.048C377.357 350.806 356.736 341.76 336.196 332.518C326.938 328.666 318.722 322.673 312.222 315.029C297.574 297.1 300.536 276.775 319.969 264.372C326.482 260.356 333.469 257.169 340.769 254.885C373.712 244.161 406.702 233.811 439.71 223.395C440.922 223.165 442.026 222.543 442.852 221.624C443.678 220.706 444.18 219.542 444.283 218.31C448.678 192.835 453.267 167.343 457.841 141.867C460.315 128.225 461.617 114.273 468.241 101.82C470.748 96.9518 473.848 92.4133 477.469 88.3081C490.588 73.7367 508.849 73.1662 522.716 87.0694C527.388 91.8611 531.485 97.1836 534.923 102.928C550.206 127.85 565.196 152.967 580.169 178.084C581.911 181.05 583.522 181.67 586.793 180.741C623.685 170.874 660.523 161.095 697.306 151.402C704.814 149.27 712.701 148.824 720.401 150.098C737.36 153.26 744.815 166.218 739.102 182.696C736.306 190 732.166 196.712 726.895 202.484C701.212 232.8 675.48 263.073 649.699 293.302C648.744 294.182 648.147 295.383 648.021 296.676C647.895 297.969 648.249 299.263 649.016 300.311C664.429 329.389 679.663 358.467 694.962 387.609C698.608 394.553 701.391 401.806 701.472 409.809C701.511 418.536 698.37 426.978 692.638 433.552C686.907 440.127 678.977 444.382 670.337 445.52C660.246 447.003 650.806 444.836 641.35 441.918C618.271 434.79 595.159 427.727 572.015 420.729C571.103 420.595 570.267 420.141 569.657 419.449C569.046 418.757 568.7 417.871 568.679 416.948C566.009 400.649 563.096 384.35 560.313 368.05C560.308 367.407 560.352 366.764 560.443 366.127C586.745 373.445 612.883 380.65 640.064 388.212" fill="%23E15C22"/>
<defs>
<linearGradient id="paint0_linear" x1="224.397" y1="427.56" x2="455.15" y2="658.31" gradientUnits="userSpaceOnUse">
<stop stop-color="%23387EB9"/>
<stop offset="1" stop-color="%23366994"/>
</linearGradient>
<linearGradient id="paint1_linear" x1="363.961" y1="578.688" x2="608.197" y2="809.402" gradientUnits="userSpaceOnUse">
<stop stop-color="%23FFDF44"/>
<stop offset="1" stop-color="%23FFC219"/>
</linearGradient>
</defs>
</svg>)
Curso integral de Apache Spark con Python que cubre desde fundamentos de Spark Core hasta SQL, MLlib, Structured Streaming y procesamiento avanzado distribuido con PySpark.
"/>
<path d="M220 724.953V836C220 826.747 517 808.24 517 761.98V650.954C517 697.221 220 715.721 220 724.974" fill="url(%23paint1_linear)"/>
<path d="M220 427.999V539.046C220 529.792 517 511.286 517 465.026V354C517 400.267 220 418.766 220 428.02" fill="url(%23paint2_linear)"/>
<path d="M647.95 381.016C646.943 378.954 646.524 377.915 645.997 376.876C631.85 349.992 617.765 323.155 603.494 296.255C602.782 295.258 602.461 294.035 602.593 292.817C602.724 291.599 603.298 290.472 604.206 289.65C626.664 263.417 649.06 237.097 671.394 210.688C672.31 209.702 672.928 208.476 673.176 207.153L653.544 212.285C626.365 219.52 599.232 226.756 572.146 233.991C569.605 234.642 568.49 233.991 567.188 231.805C551.754 206.037 536.295 180.305 520.81 154.61C520.006 153.099 518.854 151.802 517.448 150.827C516.208 157.68 514.906 164.579 513.729 171.416L500.821 244.13C500.356 246.72 499.705 249.386 499.473 251.975C499.241 254.565 497.923 255.402 495.692 256.1C463.668 266.126 431.701 276.229 399.791 286.41C398.207 286.877 396.743 287.681 395.499 288.767C421.671 299.154 447.78 309.589 474.355 320.147C473.622 320.795 472.856 321.405 472.062 321.976C455.73 332.529 439.382 343.124 423.019 353.76C422.219 354.395 421.25 354.78 420.232 354.865C419.215 354.951 418.195 354.733 417.301 354.24C397.792 345.45 378.16 336.845 358.604 328.054C349.79 324.39 341.968 318.689 335.78 311.418C321.834 294.364 324.654 275.03 343.156 263.231C349.356 259.411 356.008 256.38 362.959 254.208C394.321 244.006 425.73 234.161 457.155 224.254C458.309 224.035 459.36 223.443 460.146 222.569C460.933 221.696 461.411 220.589 461.509 219.417C465.693 195.184 470.063 170.936 474.417 146.703C476.772 133.726 478.012 120.454 484.318 108.609C486.706 103.979 489.657 99.6614 493.104 95.7565C505.594 81.8959 522.98 81.3532 536.182 94.5782C540.63 99.1362 544.53 104.199 547.803 109.664C562.353 133.369 576.625 157.261 590.88 181.153C592.538 183.975 594.072 184.564 597.187 183.68C632.31 174.295 667.381 164.992 702.401 155.773C709.549 153.744 717.057 153.321 724.389 154.532C740.535 157.54 747.632 169.866 742.193 185.541C739.531 192.487 735.589 198.872 730.571 204.362C706.12 233.2 681.621 261.996 657.077 290.751C656.168 291.588 655.599 292.73 655.479 293.96C655.358 295.19 655.696 296.421 656.426 297.418C671.1 325.077 685.604 352.736 700.169 380.458C703.64 387.062 706.29 393.962 706.367 401.574C706.404 409.876 703.414 417.906 697.957 424.16C692.5 430.413 684.951 434.461 676.725 435.544C667.118 436.955 658.13 434.892 649.128 432.117C627.155 425.337 605.152 418.618 583.117 411.962C582.248 411.834 581.453 411.403 580.872 410.744C580.29 410.086 579.96 409.243 579.941 408.365C577.399 392.861 574.626 377.357 571.976 361.853C571.971 361.241 572.013 360.629 572.1 360.023C597.14 366.985 622.026 373.837 647.903 381.031" fill="%23E15C22"/>
<defs>
<linearGradient id="paint0_linear" x1="215.525" y1="448.139" x2="513.827" y2="448.139" gradientUnits="userSpaceOnUse">
<stop stop-color="%23C30000"/>
<stop offset="1" stop-color="%23FF0101"/>
</linearGradient>
<linearGradient id="paint1_linear" x1="215.525" y1="448.139" x2="513.827" y2="448.139" gradientUnits="userSpaceOnUse">
<stop stop-color="%23C30000"/>
<stop offset="1" stop-color="%23FF0101"/>
</linearGradient>
<linearGradient id="paint2_linear" x1="215.525" y1="448.139" x2="513.827" y2="448.139" gradientUnits="userSpaceOnUse">
<stop stop-color="%23C30000"/>
<stop offset="1" stop-color="%23FF0101"/>
</linearGradient>
</defs>
</svg>)
Apache Spark es un framework de computación en clúster de código abierto, orientado al procesamiento de datos en tiempo real, que provee de una interfaz para programar clústers con paralelismo de datos implícito y tolerancia a fallos y actualmente es el proyecto de Apache más activo.
Cuéntanos tus objetivos de negocio y prepararemos una propuesta formativa bonificable totalmente ad hoc