Data Analysts Perfiles que desean evolucionar desde análisis descriptivo hacia modelos predictivos y técnicas avanzadas.
1
Totalmente práctico y aplicable
Formación en Data Science a medida
100% bonificable a través de FUNDAE
Curso TUTORIZADO por expertos


Curso de Data Science en Aula Virtual Personalizada
Nuestra modalidad AVP es una formación en directo, práctica y 100% adaptada a vuestro equipo. No trabajamos con contenidos genéricos: diseñamos la formación en función de vuestro nivel, objetivos, procesos internos y necesidades reales de aplicación.
Solicitar información
Temario 100% a medida
Creamos el temario desde cero a partir de vuestras necesidades, nivel del equipo y objetivos concretos, priorizando aquellos contenidos que realmente aporten valor en el día a día.
Proyectos personalizados
Durante la formación trabajaremos con archivos, ejemplos, informes o procesos similares a los que utiliza vuestro equipo, para que el aprendizaje sea directamente aplicable al puesto de trabajo.
Sesiones en directo con consultor experto
Un formador especialista imparte las clases en tiempo real, resolviendo dudas, revisando casos concretos y adaptando el ritmo de la formación a la evolución del grupo.
Calendario adaptado a vuestra disponibilidad
Definimos conjuntamente fechas, horarios y duración de las sesiones para facilitar la asistencia del equipo y minimizar el impacto en la operativa diaria de la empresa.
Forma a tu equipo sin costes mediante la bonificación estatal.
Este programa de Data Science para empresas es subvencionable hasta el 100%.
Calcula tu bonificación
Revisamos tu caso
Preparamos la gestión
Tu equipo realiza el curso
Aplicas la bonificación
Todos nuestros cursos son bonificables a través de FUNDAE.
Gestionamos toda la documentación por ti.
Calcula tu crédito aproximado
Crédito bonificable estimado
420€*
*Cálculo orientativo
Forma a tu equipo en Data Science con un programa práctico A Medida, tutorizado por Expertos, bonificable hasta el 100% por FUNDAE para empresas. Contáctanos.
Diseñamos una formación a medida utilizando los documentos y flujos de trabajo reales de tu empresa.

Los alumnos podrán revisar las sesiones grabadas para repasar conceptos clave, recuperar explicaciones concretas o reforzar aquellos contenidos que necesiten después de la clase en directo.

Materiales, sesiones grabadas y documentación de apoyo quedan centralizados en la plataforma para que el equipo pueda consultarlos durante y después de la formación.

La plataforma permite registrar y confirmar la asistencia de los participantes, facilitando el seguimiento de la formación y la gestión documental necesaria para la bonificación FUNDAE.

Después de la formación en directo, los alumnos podrán acceder a ejercicios prácticos para aplicar lo trabajado en clase y consolidar el aprendizaje con actividades guiadas.
Los alumnos podrán revisar las sesiones grabadas para repasar conceptos clave, recuperar explicaciones concretas o reforzar aquellos contenidos que necesiten después de la clase en directo.
Materiales, sesiones grabadas y documentación de apoyo quedan centralizados en la plataforma para que el equipo pueda consultarlos durante y después de la formación.
La plataforma permite registrar y confirmar la asistencia de los participantes, facilitando el seguimiento de la formación y la gestión documental necesaria para la bonificación FUNDAE.
Después de la formación en directo, los alumnos podrán acceder a ejercicios prácticos para aplicar lo trabajado en clase y consolidar el aprendizaje con actividades guiadas.
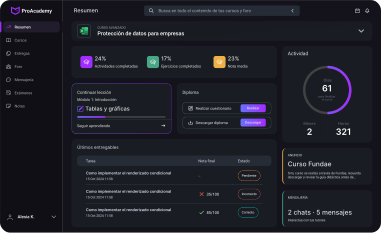
Una plataforma practica, con IA integrada y pensada para que mejores desarrollando. Se adapta a tu ritmo, te corrige al instante y te muestra tu progreso real.
Correccion magica
Feedback inteligente

Aprende de cada acierto y fallo con explicaciones claras
Encuentra todo el temario del curso aquí.

Comprender qué es Data Science, qué problemas permite resolver y cómo transforma datos en información, conocimiento, indicadores, insights y decisiones.
Diferenciar Data Science, Data Analytics, Business Intelligence, Machine Learning e Inteligencia Artificial y comprender cómo se relacionan entre sí.
Identificar funciones y responsabilidades de Data Analyst, Data Scientist, Data Engineer, ML Engineer, BI Analyst y Analytics Engineer.
Comprender cómo colaboran equipos de datos, desarrollo, soporte, producto, negocio y operaciones dentro de una organización.
Diferenciar problemas descriptivos, diagnósticos, predictivos, de clasificación, segmentación y optimización.
Distinguir datos estructurados, semiestructurados y no estructurados y variables numéricas, categóricas, ordinales, temporales, textuales y geográficas.
Comprender el ciclo de vida completo del dato desde generación y adquisición hasta análisis, consumo, archivo y eventual eliminación.
Formular preguntas analíticas a partir de necesidades empresariales y traducirlas a métricas, variables y resultados observables.
Comprender datasets, observaciones y variables y diferenciar población, muestra, característica, target y etiqueta.
Identificar fuentes habituales: bases de datos, aplicaciones, APIs, logs, CRM, ERP, tickets, hojas de cálculo y otros archivos.
Comprender qué es un notebook y su papel para combinar código, resultados, gráficos, texto y documentación.
Configurar Python, Jupyter, editor y entorno de trabajo para comenzar un proyecto de Data Science.
Comprender paquetes, librerías, dependencias y entornos virtuales.
Crear y ejecutar notebooks documentando correctamente cada fase del análisis.
Aplicar desde el inicio una metodología reproducible que permita volver a ejecutar y auditar el trabajo realizado.
Comprender la sintaxis de Python y trabajar con variables, asignaciones, enteros, decimales, booleanos, cadenas y conversiones de tipos.
Utilizar operadores aritméticos, relacionales y lógicos para construir expresiones y condiciones.
Manipular strings mediante indexación, slicing, métodos, concatenación y formato.
Crear y modificar listas y comprender sus principales operaciones.
Trabajar con tuplas y seleccionar la estructura apropiada según mutabilidad y finalidad.
Utilizar diccionarios y conjuntos para estructuras clave-valor, valores únicos y operaciones entre colecciones.
Controlar el flujo mediante `if`, `elif`, `else` y estructuras condicionales.
Crear iteraciones mediante `for` y `while`.
Utilizar `range`, `enumerate` y `zip` para construir iteraciones más expresivas.
Crear list comprehensions y dictionary comprehensions.
Definir funciones con parámetros, argumentos, valores de retorno, ámbitos de variables y expresiones lambda cuando resulten adecuadas.
Organizar código mediante módulos, paquetes e importación de funcionalidades externas.
Gestionar excepciones mediante `try` y `except` y depurar errores de sintaxis, ejecución y lógica.
Leer y escribir archivos y trabajar con fechas y horas.
Comprender clases y objetos a nivel básico y escribir código legible siguiendo convenciones profesionales.
Comprender el papel de NumPy y crear arrays multidimensionales analizando dimensiones, `shape`, `dtype` y estructura.
Utilizar indexación, slicing y máscaras booleanas para seleccionar información.
Aplicar operaciones vectorizadas, broadcasting y funciones estadísticas evitando iteraciones innecesarias.
Diferenciar listas Python y arrays NumPy según estructura, rendimiento y operaciones disponibles.
Comprender `Series` y `DataFrame` de pandas y crearlos desde distintas estructuras y fuentes.
Inspeccionar datasets mediante `head`, `tail`, `info`, `describe` y otras herramientas de exploración.
Seleccionar, filtrar y ordenar filas y columnas mediante operadores, condiciones, `loc` e `iloc`.
Crear y modificar columnas, transformar tipos y trabajar con información categórica.
Detectar y gestionar valores nulos y registros duplicados.
Aplicar funciones sobre filas o columnas y utilizar transformaciones vectorizadas cuando resulten más eficientes.
Agrupar información mediante `groupby`, calcular agregaciones y construir tablas dinámicas.
Combinar datasets mediante `merge`, `join` y `concat`.
Trabajar con fechas, series temporales, ventanas, desplazamientos y cálculos acumulativos.
Leer y exportar CSV, Excel, JSON y otros formatos habituales.
Procesar datasets de mayor tamaño de forma eficiente y encapsular transformaciones en funciones y pipelines reproducibles.
Comprender qué es una base de datos y diferenciar sistemas relacionales y no relacionales.
Entender tablas, filas, columnas, esquemas, claves primarias y claves foráneas.
Analizar relaciones uno a uno, uno a muchos y muchos a muchos mediante diagramas entidad-relación.
Comprender normalización, desnormalización y función de un sistema gestor de bases de datos.
Utilizar `SELECT`, selección de columnas, `DISTINCT`, `WHERE`, operadores lógicos, `ORDER BY` y límites de resultados.
Trabajar con funciones de agregación, `GROUP BY` y `HAVING`.
Comprender y utilizar `INNER JOIN`, `LEFT JOIN`, `RIGHT JOIN` y `FULL JOIN`.
Crear consultas que combinen múltiples tablas.
Utilizar subconsultas y Common Table Expressions para estructurar consultas complejas.
Trabajar con funciones de ventana para cálculos sobre grupos de filas relacionados.
Aplicar `CASE WHEN` y funciones relacionadas con fechas, strings y transformación de valores.
Comprender vistas y su utilización para encapsular consultas reutilizables.
Introducir índices, planes de acceso e identificación de consultas ineficientes.
Comprender transacciones y consistencia de los datos.
Conectar Python con bases de datos, ejecutar SQL desde notebooks, obtener DataFrames y combinar SQL y pandas dentro del mismo análisis.
Identificar las fuentes de datos de una organización y trabajar con CSV, Excel, JSON, XML y otros formatos tabulares o jerárquicos.
Procesar información almacenada en carpetas, múltiples archivos y fuentes heterogéneas.
Combinar datasets procedentes de diferentes sistemas manteniendo claves y relaciones coherentes.
Comprender qué es una API y los fundamentos de HTTP y de la arquitectura REST.
Diferenciar `GET`, `POST`, `PUT`, `PATCH` y `DELETE` e interpretar códigos de estado.
Trabajar con parámetros, headers y cuerpos de petición.
Consumir APIs desde Python y transformar respuestas JSON en estructuras analizables.
Gestionar paginación y grandes volúmenes de resultados.
Utilizar autenticación mediante tokens y otros mecanismos de acceso.
Controlar rate limits, errores, timeouts y estrategias de reintento.
Comprender webhooks y procesos orientados a eventos.
Introducir scraping, criterios de uso y limitaciones técnicas o legales.
Diferenciar ETL y ELT y diseñar procesos de extracción, transformación, carga y staging.
Crear procesos incrementales gestionando identificadores, duplicidades, errores y registros de ejecución.
Comprender data pipelines, data warehouses y data lakes y diseñar una arquitectura inicial de flujo de datos empresarial.
Comprender el papel de la estadística en Data Science y diferenciar estadística descriptiva e inferencial.
Identificar población, muestra, variables cualitativas y cuantitativas y escalas nominal, ordinal, intervalo y razón.
Calcular e interpretar media, mediana y moda.
Analizar rango, varianza, desviación estándar, percentiles y cuartiles.
Comprender distribuciones, asimetría, curtosis y detección de valores atípicos.
Analizar covarianza y correlación y diferenciar correlación de causalidad.
Comprender los fundamentos de probabilidad y probabilidad condicional.
Introducir el teorema de Bayes y su interpretación.
Comprender variables aleatorias y distribuciones normal, binomial, Poisson y otras relevantes.
Analizar técnicas de muestreo y comprender el Teorema Central del Límite.
Estimar intervalos de confianza e interpretar su significado.
Formular hipótesis nula y alternativa e interpretar correctamente los p-values.
Comprender errores de tipo I y II y potencia estadística.
Aplicar pruebas estadísticas básicas para comparar medias y proporciones e introducir ANOVA.
Diseñar pruebas A/B y diferenciar significancia estadística de relevancia empresarial.
Comprender por qué la calidad del dato condiciona cualquier análisis, visualización o modelo posterior.
Detectar datos ausentes, estudiar sus patrones y decidir entre eliminación, imputación u otras estrategias.
Aplicar métodos de imputación adecuados al tipo de variable y al contexto.
Detectar duplicados exactos y registros potencialmente duplicados.
Resolver inconsistencias de formato, categorías, tipos de datos, strings y fechas.
Detectar errores de rango, valores imposibles y problemas derivados de reglas de negocio incumplidas.
Identificar outliers y diferenciar una observación extrema válida de un error de captura.
Utilizar métodos estadísticos para apoyar la detección de anomalías.
Aplicar transformaciones logarítmicas y otras transformaciones cuando la distribución lo justifique.
Escalar variables y diferenciar normalización y estandarización.
Codificar variables categóricas mediante one-hot encoding y métodos adecuados para variables ordinales.
Evitar data leakage durante la preparación de datos y el entrenamiento.
Separar correctamente entrenamiento y test antes de aprender transformaciones dependientes de los datos.
Construir pipelines de transformación que reproduzcan exactamente el preprocesamiento.
Documentar reglas y checks de calidad sobre completitud, unicidad, validez, consistencia y actualidad para obtener datasets limpios y reproducibles.
Comprender el objetivo del análisis exploratorio y formular preguntas antes de empezar a producir visualizaciones.
Analizar distribuciones individuales, relaciones entre variables y segmentaciones por categorías relevantes.
Detectar patrones, comportamientos inesperados, anomalías y errores potenciales.
Analizar relaciones temporales, tendencias y cambios de comportamiento.
Crear histogramas, boxplots, gráficos de barras, scatter plots y series temporales.
Utilizar heatmaps, matrices de correlación y visualizaciones multivariantes.
Trabajar con Matplotlib y herramientas interactivas cuando aporten valor al análisis.
Aplicar principios de visualización efectiva evitando gráficos engañosos.
Seleccionar correctamente escalas, ejes, colores y recursos visuales según el mensaje.
Comunicar incertidumbre y evitar presentar estimaciones como valores exactos.
Diferenciar métrica y KPI y diseñar indicadores alineados con objetivos empresariales.
Crear métricas de soporte, producto, usuarios, ventas, operaciones, SLA, resolución, recurrencia y escalado.
Comprender hechos, dimensiones y esquemas estrella como fundamentos del modelado dimensional para BI.
Conectar datasets preparados con Power BI o herramientas equivalentes y diseñar dashboards orientados a decisiones.
Crear storytelling con datos y elaborar conclusiones ejecutivas fundamentadas en evidencia.
Comprender qué es una feature y diferenciar variables originales de variables derivadas.
Crear variables numéricas, categóricas y temporales a partir de información existente.
Extraer componentes de fechas como año, mes, semana, día y variables relacionadas con estacionalidad.
Generar ratios, tasas, agregados, ventanas móviles e información histórica evitando leakage.
Transformar distribuciones sesgadas y escalar variables cuando el algoritmo lo requiera.
Elegir técnicas de encoding según el tipo de variable.
Gestionar categorías de alta cardinalidad sin generar representaciones ineficientes.
Identificar interacciones entre variables y crear polynomial features cuando aporten valor.
Utilizar conocimiento del dominio para generar variables con significado real.
Detectar multicolinealidad y comprender sus consecuencias.
Analizar importancia preliminar de variables.
Aplicar técnicas de selección basadas en estadística y en modelos.
Utilizar regularización como mecanismo adicional para reducir variables irrelevantes.
Comprender PCA, interpretar componentes y analizar la proporción de información conservada.
Comparar feature selection y feature extraction e integrar todo el proceso dentro de pipelines reproducibles.
Comprender Machine Learning y diferenciar aprendizaje supervisado, no supervisado y por refuerzo.
Comprender features, target y separación entre datos de entrenamiento, validación y test.
Introducir regresión mediante regresión lineal, interpretación de coeficientes y regresión múltiple.
Comprender regularización L1 y L2 mediante Ridge y Lasso.
Utilizar árboles de decisión, Random Forest y Gradient Boosting para problemas de regresión.
Evaluar regresión mediante MAE, MSE, RMSE y R² interpretando correctamente cada métrica.
Comprender los problemas de clasificación y construir modelos de regresión logística.
Utilizar árboles de clasificación y Random Forest.
Introducir k-Nearest Neighbors y Support Vector Machines.
Aplicar Naive Bayes cuando las características del problema lo justifican.
Utilizar modelos ensemble y comprender bagging y boosting.
Trabajar con clasificación binaria, multiclase y multietiqueta.
Gestionar clases desbalanceadas mediante class weights, oversampling y undersampling.
Entrenar modelos mediante scikit-learn y comparar varios algoritmos sobre el mismo problema.
Seleccionar modelos considerando calidad predictiva, coste, interpretabilidad, robustez y necesidades empresariales.
Comprender cuándo utilizar aprendizaje no supervisado y diferenciar clustering de clasificación supervisada.
Preparar y escalar correctamente las variables antes de aplicar algoritmos sensibles a la distancia.
Aplicar K-Means y comprender centroides y asignación de observaciones a clusters.
Seleccionar el número de clusters mediante Elbow Method, Silhouette Score y análisis de utilidad.
Trabajar con clustering jerárquico e interpretar dendrogramas.
Introducir DBSCAN y comprender el clustering basado en densidad.
Detectar agrupaciones de formas no esféricas y ruido mediante métodos basados en densidad.
Combinar PCA y clustering para simplificar y visualizar estructuras complejas.
Crear perfiles de clusters y convertir resultados matemáticos en segmentos comprensibles.
Aplicar segmentación a clientes, usuarios y otros colectivos empresariales.
Utilizar clustering para organizar tickets, incidencias, consultas o eventos.
Comprender detección de anomalías y diferenciar anomalías globales y contextuales.
Combinar métodos estadísticos e Isolation Forest para identificar observaciones atípicas.
Detectar operaciones, usuarios, incidencias o comportamientos anómalos e introducir sistemas de recomendación colaborativos y basados en contenido.
Evaluar métodos no supervisados sin una respuesta correcta explícita y evitar atribuir a los clusters significados que los datos no demuestran.
Comprender por qué entrenar un modelo no garantiza generalización y diferenciar overfitting, underfitting, bias y variance.
Diseñar correctamente conjuntos de train, validation y test.
Aplicar cross-validation y validación estratificada según las características del problema.
Utilizar pipelines para impedir leakage durante preprocesamiento y validación.
Evaluar clasificación mediante accuracy, precision, recall y F1-score.
Interpretar matrices de confusión, sensibilidad y especificidad.
Analizar curvas ROC, AUC y Precision-Recall, especialmente en problemas desbalanceados.
Elegir thresholds teniendo en cuenta costes, riesgos y consecuencias empresariales.
Diseñar métricas personalizadas cuando las métricas estándar no reflejan correctamente el objetivo.
Comprender hiperparámetros y utilizar Grid Search y Random Search.
Introducir optimización bayesiana para búsquedas más eficientes.
Establecer baselines y comparar modelos mediante experimentos reproducibles.
Diferenciar mejora estadística o técnica de una mejora empresarialmente relevante.
Analizar interpretabilidad global y local mediante feature importance, permutation importance, SHAP y técnicas relacionadas.
Detectar relaciones espurias, analizar fairness entre segmentos, registrar experimentos y seleccionar el modelo final justificando sus trade-offs.
Comprender las particularidades de las series temporales e identificar tendencia, estacionalidad, ciclos y autocorrelación.
Crear lags, medias móviles y otras variables temporales evitando utilizar información futura.
Diseñar baselines de forecasting e introducir modelos clásicos como ARIMA y familias relacionadas.
Evaluar forecasting mediante métricas adecuadas y backtesting temporal.
Aplicar forecasting y detección de anomalías sobre demanda, ventas, tickets, incidencias, carga y otras series empresariales.
Comprender NLP y realizar limpieza, normalización, tokenización y análisis de frecuencia de términos.
Utilizar Bag of Words y TF-IDF como representaciones clásicas de documentos.
Aplicar clasificación de texto, análisis de sentimiento y agrupación temática de tickets o consultas.
Comprender embeddings y similitud semántica para representar significado.
Introducir redes neuronales mediante neuronas, capas, pesos, funciones de activación, entrenamiento e inferencia.
Comprender conceptualmente backpropagation y cuándo Deep Learning aporta ventajas frente a modelos tradicionales.
Identificar arquitecturas aplicables a datos tabulares, imágenes, secuencias y texto.
Comprender transformers a nivel funcional y diferenciar modelos predictivos de modelos generativos.
Comprender LLM, prompting, structured outputs, embeddings, búsqueda semántica y RAG.
Diseñar soluciones híbridas que combinen modelos tradicionales y GenAI y evaluar cuándo la complejidad adicional está realmente justificada.
Diferenciar notebook experimental y solución productiva y organizar proyectos separando datos, código, notebooks, configuraciones, tests y modelos.
Utilizar Git mediante repositorios, commits, ramas, Pull Requests, merges y resolución de conflictos.
Mantener notebooks reproducibles y utilizar entornos virtuales, dependencias, configuraciones, variables de entorno y secretos.
Convertir notebooks en módulos, funciones y paquetes reutilizables y aplicar logging estructurado.
Crear tests unitarios, pruebas sobre transformaciones, validaciones de calidad de datos y tests mínimos de modelos.
Garantizar reproducibilidad mediante versionado de código, datasets, modelos, parámetros y artefactos cuando corresponda.
Construir pipelines de entrenamiento que automaticen preprocesamiento, entrenamiento, evaluación y serialización de modelos.
Diseñar predicciones batch e inferencia online y exponer modelos mediante APIs con FastAPI o tecnologías equivalentes.
Crear imágenes y contenedores Docker para encapsular dependencias y entorno de ejecución.
Introducir CI/CD para ejecutar tests, validaciones y controles antes del despliegue.
Aplicar experiment tracking, model registry y versionado de modelos como fundamentos de MLOps.
Monitorizar servicios mediante latencia, disponibilidad, distribución de variables, data drift, concept drift y calidad cuando llegan nuevas etiquetas.
Diseñar alertas, criterios de degradación, procedimientos de reentrenamiento y arquitecturas batch o real-time.
Comprender cloud computing, costes de procesamiento y modelos, mínimos privilegios, seguridad de credenciales y protección de datos personales mediante anonimización o pseudonimización.
Aplicar gobierno del dato, lineage, model cards, documentación, evaluación de sesgos y riesgos, uso responsable, supervisión humana y mejora continua.
Definir un problema empresarial, usuario destinatario, pregunta analítica, objetivos y decisiones que deberá apoyar la solución.
Identificar fuentes y crear un modelo inicial de datos integrando archivos, bases de datos, APIs y consultas SQL.
Unificar diferentes fuentes y analizar completitud, inconsistencias, duplicados, valores ausentes y demás problemas de calidad.
Documentar transformaciones y preparar un dataset limpio y reproducible.
Desarrollar análisis estadístico, análisis exploratorio, visualizaciones y KPIs y estructurar un dashboard o informe de resultados.
Formular hipótesis verificables y preparar features adecuadas para el problema seleccionado.
Separar entrenamiento, validación y test, establecer un baseline y entrenar varios modelos candidatos.
Evaluar modelos con métricas apropiadas, cross-validation y optimización de hiperparámetros.
Analizar errores, interpretar predicciones, comprobar posibles sesgos y comparar el modelo seleccionado con el baseline.
Justificar la solución desde perspectivas técnica y empresarial e incorporar series temporales, NLP o detección de anomalías cuando resulte relevante.
Diseñar inferencia mediante proceso batch o API y organizar el proyecto con estructura profesional, Git, tests, dependencias y configuración.
Preparar contenedor y estrategia de despliegue cuando el escenario lo requiera.
Definir monitorización de servicio, datos, drift, degradación y procedimiento de reentrenamiento.
Documentar datos, modelo, limitaciones, riesgos, uso previsto, README técnico y procedimiento de ejecución.
Elaborar un resumen ejecutivo y presentar la solución mediante datos, visualizaciones, métricas, metodología, decisiones, limitaciones y oportunidades de mejora.
Profesionales de soporte y operaciones
Personas que trabajan con incidencias, clientes, logs, plataformas o procesos y necesitan analizar datos, consultar bases de datos, estudiar KPIs y colaborar con equipos técnicos.
Perfiles de Business Intelligence y reporting
Profesionales que trabajan con dashboards, Excel, KPIs o informes y quieren avanzar hacia Python, SQL, estadística, análisis avanzado y Machine Learning.
Profesionales de áreas funcionales
Personas de negocio, producto, marketing, finanzas, operaciones, RRHH o atención al cliente que quieren desarrollar competencias técnicas relacionadas con datos.
Personas que quieren iniciarse en Data Science
Alumnos sin conocimientos previos sólidos de programación que necesitan una progresión ordenada desde los fundamentos.
Analistas de datos que quieren evolucionar
Profesionales que ya realizan análisis descriptivos y quieren incorporar programación, estadística, modelos predictivos y técnicas de Machine Learning.
Profesionales que trabajan entre negocio y tecnología
Perfiles que necesitan actuar como nexo entre usuarios, soporte, desarrollo, integraciones, producto, datos y dirección.
Experiencias reales de equipos que ya han trabajado con nosotros.
+16
años de liderazgo
+3.500
empresas formadas
Nuestra empresa decidió contratar formación con Imagina aprovechando los créditos de FUNDAE, y fue una gran decisión. La modalidad online nos permitió adaptar los horarios a nuestro equipo. La formación ha sido práctica, clara y útil para el día a día. Es sencillo de gestionar y los resultados son excepcionales.

Hugo Gutiérrez
Analista Financiero
Gracias a Imagina, la eficiencia de nuestras sesiones de capacitación ha mejorado drásticamente. Es sencillo de usar y los resultados son excepcionales.
Luis Martínez
Administrativo
Gracias al aula virtual de Imagina siempre son capaces de adaptar los cursos a nuestras necesidades. El contenido fue muy completo y práctico.
Elena Pérez
Responsable de Recursos Humanos
Mejor de lo esperado, la modalidad online se adapta a nuestros horarios. La ayuda con la bonificación FUNDAE hizo todo más fácil. Práctico y necesario.
Alejandro Sánchez
Director de Operaciones
Nuestra empresa decidió contratar formación con Imagina aprovechando los créditos de FUNDAE, y fue una gran decisión. La modalidad online nos permitió adaptar los horarios a nuestro equipo. La formación ha sido práctica, clara y útil para el día a día. Es sencillo de gestionar y los resultados son excepcionales.
Hugo Gutiérrez
Analista Financiero
Gracias a Imagina, la eficiencia de nuestras sesiones de capacitación ha mejorado drásticamente. Es sencillo de usar y los resultados son excepcionales.
Luis Martínez
Administrativo
Gracias al aula virtual de Imagina siempre son capaces de adaptar los cursos a nuestras necesidades. El contenido fue muy completo y práctico.
Elena Pérez
Responsable de Recursos Humanos
Mejor de lo esperado, la modalidad online se adapta a nuestros horarios. La ayuda con la bonificación FUNDAE hizo todo más fácil. Práctico y necesario.
Alejandro Sánchez
Director de Operaciones
480.000 alumnos formados en Imagina
Explora las respuestas a las preguntas que guian a nuestra comunidad. Aqui encontraras claridad sobre como funciona todo, desde el acceso hasta los detalles de los cursos. Si buscas respuestas, este es el lugar para comenzar.
No. El programa incluye Python desde sus fundamentos y avanza progresivamente hacia pandas, Machine Learning y producción.
Sí. Incluye modelado relacional, consultas, joins, funciones de ventana, CTE, rendimiento y conexión desde Python.
Sí. Se cubren estadística descriptiva, probabilidad, inferencia, hipótesis, intervalos, pruebas A/B y significancia.
Sí. El programa incluye regresión, clasificación, clustering, detección de anomalías, ensembles y técnicas relacionadas.
Sí. Se introducen redes neuronales, entrenamiento, inferencia, backpropagation, transformers y escenarios donde aportan valor.
Sí. Se estudian LLM, prompting, structured outputs, embeddings, búsqueda semántica, RAG y soluciones híbridas.
Sí. Incluye predicciones batch, APIs, FastAPI, Docker, CI/CD y fundamentos de serving.
Sí. Se trabajan experiment tracking, model registry, versionado, monitorización, drift, alertas y reentrenamiento.
Sí. El curso incorpora protección de datos sensibles, anonimización, pseudonimización, lineage, model cards, sesgos y supervisión humana.
La formación puede ser bonificable a través de FUNDAE hasta el 100% cuando la empresa dispone de crédito suficiente y se cumplen los requisitos aplicables a la Formación Programada por las Empresas.
¿Tienes dudas?
Estamos aqui para ayudarte
No. El programa incluye Python desde sus fundamentos y avanza progresivamente hacia pandas, Machine Learning y producción.
¿Tienes dudas?
Estamos aqui para ayudarte
Sí. Incluye modelado relacional, consultas, joins, funciones de ventana, CTE, rendimiento y conexión desde Python.
¿Tienes dudas?
Estamos aqui para ayudarte
Sí. Se cubren estadística descriptiva, probabilidad, inferencia, hipótesis, intervalos, pruebas A/B y significancia.
¿Tienes dudas?
Estamos aqui para ayudarte
Sí. El programa incluye regresión, clasificación, clustering, detección de anomalías, ensembles y técnicas relacionadas.
¿Tienes dudas?
Estamos aqui para ayudarte
Sí. Se introducen redes neuronales, entrenamiento, inferencia, backpropagation, transformers y escenarios donde aportan valor.
¿Tienes dudas?
Estamos aqui para ayudarte
Sí. Se estudian LLM, prompting, structured outputs, embeddings, búsqueda semántica, RAG y soluciones híbridas.
¿Tienes dudas?
Estamos aqui para ayudarte
Sí. Incluye predicciones batch, APIs, FastAPI, Docker, CI/CD y fundamentos de serving.
¿Tienes dudas?
Estamos aqui para ayudarte
Sí. Se trabajan experiment tracking, model registry, versionado, monitorización, drift, alertas y reentrenamiento.
¿Tienes dudas?
Estamos aqui para ayudarte
Sí. El curso incorpora protección de datos sensibles, anonimización, pseudonimización, lineage, model cards, sesgos y supervisión humana.
¿Tienes dudas?
Estamos aqui para ayudarte
La formación puede ser bonificable a través de FUNDAE hasta el 100% cuando la empresa dispone de crédito suficiente y se cumplen los requisitos aplicables a la Formación Programada por las Empresas.
¿Tienes dudas?
Estamos aqui para ayudarte
Descubre Que es Microsoft Power Automate o Microsoft Flow: Guía Completa de la Herramienta de Automatización de Tareas de Microsoft
Descubre cómo instalar Kali Linux fácilmente y empieza a usar esta herramienta esencial para pruebas de penetración y análisis forense digital.
Conoce los cursos bonificados para trabajadores 2025 más demandados y cómo puedes inscribir a tus empleados para aprovechar los créditos formativos de FUNDAE.
Conoce los cursos obligatorios para empresas 2025 y cómo asegurar que tu organización cumpla con las normativas actuales sin riesgos de sanciones.
Descubre los mejores cursos bonificados para empresas en 2025 por la Fundación Tripartita. Aumenta la productividad de tu equipo sin costes adicionales.
"/>
<path fill-rule="evenodd" clip-rule="evenodd" d="M641.769 554.373C641.769 554.373 662.878 560.761 675.142 566.985C679.397 569.145 686.76 573.454 692.07 579.112C697.273 584.653 699.809 590.269 699.809 590.269L783 730.94L648.54 731L585.663 612.582C585.663 612.582 572.788 590.396 564.866 583.963C558.257 578.597 555.439 576.686 548.905 576.686C544.356 576.686 516.957 576.686 516.957 576.686L516.982 730.915L398 730.965V337H636.932C636.932 337 745.758 338.968 745.758 442.806C745.758 546.644 641.769 554.373 641.769 554.373ZM590.016 422.456L517.986 422.41L517.95 489.398L590.016 489.375C590.016 489.375 623.389 489.271 623.389 455.299C623.389 420.643 590.016 422.456 590.016 422.456Z" fill="url(%23paint1_linear)"/>
<defs>
<linearGradient id="paint0_linear" x1="110" y1="191" x2="543.985" y2="837.814" gradientUnits="userSpaceOnUse">
<stop stop-color="%23CBCED0"/>
<stop offset="1" stop-color="%2384838B"/>
</linearGradient>
<linearGradient id="paint1_linear" x1="398" y1="337" x2="791.895" y2="721.897" gradientUnits="userSpaceOnUse">
<stop stop-color="%23276DC3"/>
<stop offset="1" stop-color="%23165CAA"/>
</linearGradient>
</defs>
</svg>)
Formación práctica en R para importar, limpiar, transformar, analizar, visualizar y comunicar datos mediante proyectos reproducibles y orientados a negocio.
"/>
<path d="M462.001 792.691C631.881 792.691 621.281 719.021 621.281 719.021L621.091 642.701H458.971V619.791H685.471C685.471 619.791 794.181 632.121 794.181 460.701C794.181 289.281 699.301 295.371 699.301 295.371H642.671V374.911C642.671 374.911 645.731 469.791 549.311 469.791H388.521C388.521 469.791 298.191 468.331 298.191 557.101V703.851C298.191 703.851 284.471 792.671 462.001 792.671V792.691ZM551.391 741.371C547.565 741.375 543.775 740.625 540.239 739.164C536.703 737.703 533.489 735.559 530.781 732.856C528.073 730.153 525.924 726.943 524.457 723.409C522.99 719.875 522.234 716.087 522.231 712.261C522.227 708.434 522.977 704.644 524.438 701.107C525.899 697.57 528.042 694.355 530.745 691.647C533.448 688.938 536.658 686.788 540.192 685.32C543.726 683.852 547.514 683.094 551.341 683.091C555.17 683.077 558.964 683.819 562.506 685.272C566.049 686.726 569.27 688.863 571.986 691.561C574.702 694.26 576.86 697.467 578.337 701C579.813 704.533 580.579 708.322 580.591 712.151V712.201C580.596 719.93 577.532 727.345 572.071 732.815C566.61 738.285 559.201 741.363 551.471 741.371H551.391Z" fill="url(%23paint1_linear)"/>
<defs>
<linearGradient id="paint0_linear" x1="191.93" y1="192.868" x2="525.539" y2="525.735" gradientUnits="userSpaceOnUse">
<stop stop-color="%23387EB9"/>
<stop offset="1" stop-color="%23366994"/>
</linearGradient>
<linearGradient id="paint1_linear" x1="393.096" y1="411.662" x2="745.197" y2="744.49" gradientUnits="userSpaceOnUse">
<stop stop-color="%23FFDF44"/>
<stop offset="1" stop-color="%23FFC219"/>
</linearGradient>
</defs>
</svg>)
Curso de Data Science con Python para empresas, orientado a analizar datos, construir modelos predictivos, trabajar con IA, automatizar flujos analíticos y llevar soluciones a producción.
Aprende a recopilar, limpiar y preparar datos para visualizarlos y gestionarlos con Python.
Cuéntanos tus objetivos de negocio y prepararemos una propuesta formativa bonificable totalmente ad hoc