Recuperación de los fundamentos del programa original Mantiene almacenamiento, ANSI-SPARC, modelos de datos, bases distribuidas, copias de seguridad y arquitectura sin sacrificar el aprendizaje real de SQL.
1
Totalmente práctico y aplicable
Formación en SQL a medida
100% bonificable a través de FUNDAE
Curso TUTORIZADO por expertos


Curso de SQL en Aula Virtual Personalizada
Nuestra modalidad AVP es una formación en directo, práctica y 100% adaptada a vuestro equipo. No trabajamos con contenidos genéricos: diseñamos la formación en función de vuestro nivel, objetivos, procesos internos y necesidades reales de aplicación.
Solicitar información
Temario 100% a medida
Creamos el temario desde cero a partir de vuestras necesidades, nivel del equipo y objetivos concretos, priorizando aquellos contenidos que realmente aporten valor en el día a día.
Proyectos personalizados
Durante la formación trabajaremos con archivos, ejemplos, informes o procesos similares a los que utiliza vuestro equipo, para que el aprendizaje sea directamente aplicable al puesto de trabajo.
Sesiones en directo con consultor experto
Un formador especialista imparte las clases en tiempo real, resolviendo dudas, revisando casos concretos y adaptando el ritmo de la formación a la evolución del grupo.
Calendario adaptado a vuestra disponibilidad
Definimos conjuntamente fechas, horarios y duración de las sesiones para facilitar la asistencia del equipo y minimizar el impacto en la operativa diaria de la empresa.
Forma a tu equipo sin costes mediante la bonificación estatal.
Este programa de SQL para empresas es subvencionable hasta el 100%.
Calcula tu bonificación
Revisamos tu caso
Preparamos la gestión
Tu equipo realiza el curso
Aplicas la bonificación
Todos nuestros cursos son bonificables a través de FUNDAE.
Gestionamos toda la documentación por ti.
Calcula tu crédito aproximado
Crédito bonificable estimado
420€*
*Cálculo orientativo
Diseñamos una formación a medida utilizando los documentos y flujos de trabajo reales de tu empresa.

Los alumnos podrán revisar las sesiones grabadas para repasar conceptos clave, recuperar explicaciones concretas o reforzar aquellos contenidos que necesiten después de la clase en directo.

Materiales, sesiones grabadas y documentación de apoyo quedan centralizados en la plataforma para que el equipo pueda consultarlos durante y después de la formación.

La plataforma permite registrar y confirmar la asistencia de los participantes, facilitando el seguimiento de la formación y la gestión documental necesaria para la bonificación FUNDAE.

Después de la formación en directo, los alumnos podrán acceder a ejercicios prácticos para aplicar lo trabajado en clase y consolidar el aprendizaje con actividades guiadas.
Los alumnos podrán revisar las sesiones grabadas para repasar conceptos clave, recuperar explicaciones concretas o reforzar aquellos contenidos que necesiten después de la clase en directo.
Materiales, sesiones grabadas y documentación de apoyo quedan centralizados en la plataforma para que el equipo pueda consultarlos durante y después de la formación.
La plataforma permite registrar y confirmar la asistencia de los participantes, facilitando el seguimiento de la formación y la gestión documental necesaria para la bonificación FUNDAE.
Después de la formación en directo, los alumnos podrán acceder a ejercicios prácticos para aplicar lo trabajado en clase y consolidar el aprendizaje con actividades guiadas.
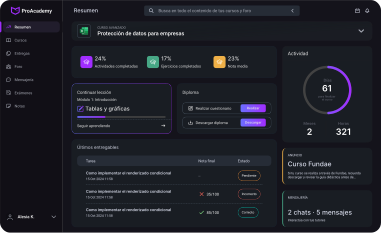
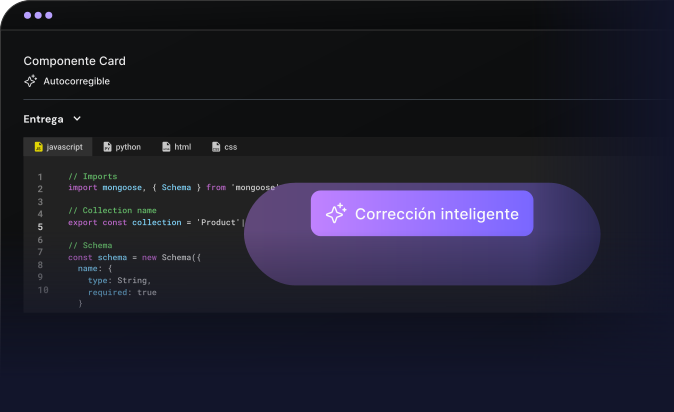
Una plataforma practica, con IA integrada y pensada para que mejores desarrollando. Se adapta a tu ritmo, te corrige al instante y te muestra tu progreso real.
Correccion magica
Feedback inteligente

Aprende de cada acierto y fallo con explicaciones claras
Encuentra todo el temario del curso aquí.

Qué es un sistema de información y cómo transforma datos en información útil para una organización.
Tipos de sistemas de información y relación con procesos operativos, analíticos y de gestión.
Personas, procesos, datos, aplicaciones e infraestructura como elementos de un sistema de información.
Jerarquía de datos: caracteres, campos, registros, archivos, tablas, bases de datos y sistemas de información.
Representación de información estructurada, semiestructurada y no estructurada.
El archivo como estructura básica de almacenamiento y características fundamentales.
Clasificación y tipos de archivos según contenido, organización y finalidad.
Extensiones, formatos, registros y operaciones habituales sobre archivos.
Ficheros, directorios, rutas y variables de entorno relacionadas con herramientas de bases de datos.
Acceso secuencial, directo e indexado a registros.
Asignación contigua, enlazada e indexada como fundamentos de organización física del almacenamiento.
Problemas de los sistemas basados exclusivamente en archivos: redundancia, aislamiento, inconsistencia y acceso concurrente.
Evolución desde archivos independientes hasta bases de datos gestionadas.
Diferencia entre archivo, tabla, base de datos, servidor y sistema gestor de bases de datos.
Primer recorrido por un entorno relacional y por las herramientas que se utilizarán durante el curso.
Qué es un Sistema Gestor de Bases de Datos y qué responsabilidades asume.
Objetivos de un SGBD: persistencia, integridad, concurrencia, seguridad, recuperación e independencia.
Componentes principales de un motor de base de datos.
Procesador de consultas, gestor de almacenamiento, catálogo, transacciones y control de acceso.
Usuarios finales, desarrolladores y administradores como perfiles de interacción con el SGBD.
Utilidades habituales de administración, consulta, importación, exportación y mantenimiento.
PostgreSQL, MySQL, SQL Server y otros sistemas presentes en entornos empresariales.
Diferencias generales entre soluciones comerciales, open source, locales y gestionadas en la nube.
Arquitectura ANSI-SPARC como modelo de separación de los datos.
Nivel interno y representación física de la información.
Nivel conceptual y definición lógica global.
Nivel externo y vistas adaptadas a distintos usuarios o aplicaciones.
Independencia lógica e independencia física de los datos.
Transformaciones entre niveles y papel del catálogo o diccionario de datos.
Modelo de referencia ANSI y utilidad actual de la separación entre almacenamiento, modelo y consumo.
Objetivos del diseño de una base de datos antes de implementar tablas.
Diferencias entre modelo conceptual, lógico y físico.
Modelos de datos basados en registros y otras aproximaciones históricas.
Modelo jerárquico y organización padre-hijo.
Modelo en red y relaciones entre múltiples registros.
Modelo relacional y representación mediante tablas relacionadas.
Modelos orientados a objetos y diferencias respecto al modelo relacional.
Selección del modelo según necesidades de información y aplicaciones.
Modelo entidad-relación como herramienta de diseño conceptual.
Entidades y criterios para identificarlas correctamente.
Atributos simples, compuestos, derivados, opcionales y multivaluados.
Claves candidatas e identificadores de entidades.
Relaciones y cardinalidades uno a uno, uno a muchos y muchos a muchos.
Entidades débiles, relaciones recursivas, generalización y especialización.
Calidad del esquema conceptual y detección de ambigüedades, redundancias y reglas no representadas.
Arquitectura lógica del modelo relacional.
Relaciones, tablas, filas, columnas y dominios.
Esquema conceptual, externo e interno en una implementación relacional.
Tablas físicas y vistas lógicas sobre la información.
Claves candidatas, primarias, alternativas y foráneas.
Integridad de entidad y unicidad de los registros.
Integridad de clave y restricciones asociadas a los identificadores.
Integridad referencial entre tablas relacionadas.
Conversión de entidades en tablas.
Conversión de relaciones uno a uno y uno a muchos.
Conversión de relaciones muchos a muchos mediante tablas asociativas.
Conversión de relaciones recursivas.
Eliminación de atributos compuestos y transformación de atributos multivaluados.
Conversión de jerarquías de generalización y especialización.
Metodología completa para comprobar que el modelo relacional conserva las reglas del modelo conceptual.
Finalidad de la normalización dentro del diseño relacional.
Redundancia y problemas derivados de almacenar repetidamente la misma información.
Anomalías de inserción.
Anomalías de actualización.
Anomalías de eliminación.
Dependencias funcionales entre atributos.
Determinantes, claves y atributos dependientes.
Primera Forma Normal y atomicidad.
Transformación de estructuras repetitivas para cumplir 1FN.
Segunda Forma Normal y eliminación de dependencias parciales.
Tercera Forma Normal y eliminación de dependencias transitivas.
Descomposición de tablas preservando información y relaciones.
Comprobación de claves y referencias después de normalizar.
Introducción a la desnormalización y motivos por los que puede aparecer en determinados diseños.
Validación de un modelo completo desde los requisitos hasta la Tercera Forma Normal.
Qué es SQL y relación con el modelo relacional.
Objetivos y capacidades de SQL como lenguaje de bases de datos.
SQL estándar y dialectos específicos de los principales SGBD.
Portabilidad entre PostgreSQL, MySQL y SQL Server.
Categorías del lenguaje: DDL, DML, DQL, DCL y TCL.
Lenguaje de definición, manipulación, consulta, control y transacciones.
Modo interactivo mediante clientes SQL.
Ejecución de SQL desde programas y aplicaciones.
Arquitectura cliente-servidor en una operación SQL.
Conectividad mediante ODBC, JDBC y otros controladores.
Instalación y configuración inicial de un SGBD en un entorno de aprendizaje.
Primeros pasos con herramientas como pgAdmin, phpMyAdmin o SQL Server Management Studio.
Creación y selección de conexiones, servidores, bases y esquemas.
Identificadores, palabras reservadas, comentarios y convenciones de nomenclatura.
Tipos de datos y principales diferencias entre motores.
Creación de bases de datos y esquemas.
Organización de objetos mediante esquemas o espacios lógicos.
Eliminación de bases de datos y precauciones asociadas.
CREATE TABLE y estructura de una definición de tabla.
Tipos de datos numéricos, texto, booleanos, fecha y hora.
Selección del tipo de dato adecuado según naturaleza y rango de la información.
Definición de claves primarias mediante PRIMARY KEY.
Restricciones NOT NULL y control de obligatoriedad.
Restricciones UNIQUE.
Restricciones CHECK.
Valores DEFAULT.
FOREIGN KEY y relaciones entre tablas.
Acciones referenciales ante UPDATE y DELETE.
ALTER TABLE para evolucionar una estructura existente.
DROP TABLE y gestión de dependencias entre objetos.
Diferencias entre definir estructuras y manipular los datos almacenados.
INSERT para añadir registros.
Inserción especificando las columnas de destino.
Inserción de todos los valores de una fila.
Inserción de múltiples registros.
Valores generados automáticamente y valores por defecto.
Inserción de resultados obtenidos desde otras consultas.
Importación y carga masiva de información.
Validación de tipos y restricciones durante la inserción.
UPDATE para modificar registros existentes.
Modificación de una o varias columnas.
Uso de condiciones para limitar una actualización.
DELETE para eliminar filas seleccionadas.
Eliminación de todas las filas y diferencia conceptual frente a eliminar la tabla.
Comprobación previa y estrategias para evitar modificaciones o eliminaciones accidentales.
Estructura general de una sentencia SELECT.
SELECT y selección de columnas.
FROM y definición del origen de los datos.
Uso de alias para columnas y tablas.
WHERE y filtrado de registros.
Operadores aritméticos y de comparación.
Operadores lógicos AND, OR y NOT.
Condiciones BETWEEN, IN y NOT IN.
Búsquedas textuales mediante LIKE.
Evaluación de valores NULL con IS NULL e IS NOT NULL.
DISTINCT y eliminación de filas duplicadas del resultado.
Columnas calculadas mediante expresiones.
CASE y creación de lógica condicional.
Funciones de texto, números, fechas, conversiones y tratamiento de valores NULL.
Composición de filtros y expresiones para resolver consultas empresariales.
ORDER BY y ordenación ascendente o descendente.
Ordenación mediante múltiples criterios.
Limitación del número de resultados y diferencias básicas entre dialectos.
Funciones de agregación y diferencia respecto a funciones aplicadas por fila.
COUNT y conteo de registros o valores.
SUM para calcular acumulados.
AVG para valores medios.
MIN y MAX para localizar extremos.
Comportamiento de las funciones agregadas frente a NULL.
GROUP BY y formación de grupos.
Agrupación mediante una o varias columnas.
WHERE como filtro previo a la agregación.
HAVING como filtro posterior sobre grupos.
Uso de HAVING sin GROUP BY cuando resulte válido en el motor correspondiente.
Combinación de SELECT, WHERE, GROUP BY, HAVING y ORDER BY en informes resumidos.
Necesidad de combinar datos almacenados en tablas distintas.
Relación entre claves primarias y claves foráneas dentro de una consulta.
Sintaxis explícita de JOIN y ventajas frente a las combinaciones implícitas.
INNER JOIN y composición interna.
LEFT OUTER JOIN y conservación de las filas de la tabla izquierda.
RIGHT OUTER JOIN y diferencias de disponibilidad entre motores.
FULL OUTER JOIN y concepto de composición externa completa.
SELF JOIN para relacionar registros de una tabla consigo mismos.
CROSS JOIN y producto cartesiano.
JOIN entre más de dos tablas.
Condiciones ON y diferencia respecto a WHERE.
Alias para facilitar consultas con múltiples tablas.
Duplicados derivados de relaciones uno a muchos.
Detección de productos cartesianos accidentales.
Resolución de consultas empresariales utilizando varias entidades relacionadas.
Qué es una subconsulta y cuándo puede utilizarse.
Subconsultas escalares con un único resultado.
Subconsultas que devuelven varias filas.
Subconsultas en la cláusula WHERE.
Uso de IN con resultados obtenidos mediante otra consulta.
Uso introductorio de EXISTS.
Uso introductorio de NOT EXISTS.
Concepto de subconsulta correlacionada sin entrar todavía en optimización.
Subconsultas dentro de HAVING.
Subconsultas como tablas derivadas.
UNION para combinar conjuntos compatibles.
UNION ALL y conservación de duplicados.
INTERSECT para obtener elementos comunes cuando el motor lo soporta.
EXCEPT y operaciones de diferencia entre conjuntos.
Selección básica entre JOIN, operación de conjuntos o subconsulta según el resultado buscado.
Concepto de vista como consulta almacenada.
CREATE VIEW y creación de vistas reutilizables.
Uso de vistas para simplificar consultas recurrentes.
Vistas como capa de abstracción entre tablas y usuarios.
Limitaciones generales de actualización mediante vistas.
Concepto de transacción como unidad lógica de trabajo.
Propiedades ACID.
COMMIT y confirmación de cambios.
ROLLBACK y reversión de operaciones.
SAVEPOINT y recuperación parcial dentro de una transacción.
Identificación de operaciones que deben ejecutarse de forma atómica.
Introducción a múltiples sesiones accediendo simultáneamente a la misma información.
Concepto de bloqueo.
Introducción a los niveles de aislamiento sin profundizar en sus estrategias de optimización.
Consistencia de la información ante errores durante procesos de actualización.
Diferencia entre SQL declarativo y lenguajes procedurales asociados a los motores.
Introducción a PL/SQL como referencia histórica y al modelo de programación almacenada.
PL/pgSQL, Transact-SQL y programación almacenada de MySQL según el SGBD utilizado.
Variables y tipos de datos dentro de bloques procedurales.
Operadores y expresiones en programación SQL.
Condiciones y estructuras básicas de control.
Procedimientos almacenados sencillos.
Funciones almacenadas y diferencias generales respecto a procedimientos.
Parámetros de entrada y salida.
Usuarios, roles y separación de responsabilidades.
GRANT y REVOKE para asignar o retirar privilegios.
Principio de mínimo privilegio.
Concepto básico de índice y relación entre índices, claves y acceso a datos, sin abordar todavía estrategias de optimización.
Copias de seguridad completas, diferenciales e incrementales según las posibilidades del SGBD y las herramientas empleadas.
Restauración, verificación de copias y necesidad de probar periódicamente los procedimientos de recuperación.
Qué es una base de datos distribuida y diferencias frente a una base centralizada.
Ventajas relacionadas con disponibilidad, proximidad de datos y escalabilidad.
Desventajas derivadas de complejidad, coordinación, latencia y consistencia.
Funciones de un sistema gestor de bases de datos distribuidas.
Bases de datos distribuidas homogéneas.
Bases de datos distribuidas heterogéneas.
Fragmentación horizontal y vertical de la información.
Replicación y distribución de copias.
Etapas generales de diseño de una arquitectura distribuida.
Problemas de localización, transparencia, consistencia, concurrencia y recuperación.
Principios históricos recogidos en las reglas de C. J. Date para sistemas distribuidos y su interpretación conceptual actual.
Introducción al coste de las consultas y a por qué dos sentencias equivalentes pueden comportarse de forma diferente.
Diferencia entre escribir SQL correcto y escribir SQL eficiente.
Conceptos que se dejan expresamente para el siguiente nivel: CTE, funciones de ventana, indexación avanzada y planes de ejecución.
Preparación del alumno para SQL Avanzado y Optimización de Consultas sin adelantar las técnicas que constituyen su contenido principal.
Análisis de requisitos para un sistema de información empresarial.
Identificación de entidades, atributos, claves, relaciones y cardinalidades.
Construcción del modelo entidad-relación.
Conversión del diseño conceptual al modelo relacional.
Normalización del esquema hasta Tercera Forma Normal cuando corresponda.
Creación de la base de datos, esquemas, tablas, tipos y restricciones.
Preparación y carga de un conjunto de datos coherente con el dominio diseñado.
Ejecución controlada de altas, modificaciones y eliminaciones mediante SQL.
Desarrollo de consultas con filtros, funciones, condiciones y columnas calculadas.
Creación de consultas agrupadas mediante funciones de agregación, GROUP BY y HAVING.
Recuperación de información relacionada mediante diferentes tipos de JOIN.
Incorporación de subconsultas y operaciones de conjuntos cuando resulten apropiadas.
Creación de vistas, usuarios y permisos básicos adaptados a distintos perfiles.
Diseño de una operación transaccional y propuesta de un procedimiento almacenado relacionado con el proceso.
Documentación de la solución y detección de consultas candidatas para su posterior estudio en SQL Avanzado y Optimización de Consultas.
Desarrolladores y programadores
Profesionales que necesitan almacenar, consultar y modificar información desde aplicaciones y quieren disponer de una base sólida antes de estudiar rendimiento y optimización.
Analistas de datos
Perfiles que necesitan recuperar, relacionar, filtrar y resumir información mediante SQL antes de trabajar con técnicas analíticas avanzadas.
Profesionales de Business Intelligence
Usuarios de herramientas de reporting y visualización que necesitan comprender el modelo de datos y las consultas utilizadas en los orígenes de información.
Técnicos de sistemas y aplicaciones
Profesionales que gestionan aplicaciones conectadas a SGBD y necesitan comprender tablas, relaciones, consultas, transacciones, permisos y recuperación de datos.
Analistas funcionales
Perfiles encargados de transformar necesidades de negocio en requisitos de información y modelos estructurados.
Administradores de bases de datos junior
Profesionales que empiezan a trabajar con SGBD y necesitan dominar fundamentos antes de avanzar hacia rendimiento, monitorización y administración especializada.
Equipos de reporting y control de gestión
Usuarios que necesitan obtener indicadores y combinar datos procedentes de diferentes tablas mediante consultas SQL.
Profesionales de QA y testing
Perfiles que necesitan preparar datos, validar resultados y comprobar el efecto que las aplicaciones producen sobre las bases de datos.
Equipos de soporte técnico
Profesionales que investigan incidencias relacionadas con aplicaciones, datos y procesos y necesitan consultar información directamente en el SGBD.
Perfiles técnicos en formación
Personas que quieren continuar posteriormente hacia desarrollo, datos, BI, administración de bases de datos o SQL avanzado.
Experiencias reales de equipos que ya han trabajado con nosotros.
+16
años de liderazgo
+3.500
empresas formadas
Nuestra empresa decidió contratar formación con Imagina aprovechando los créditos de FUNDAE, y fue una gran decisión. La modalidad online nos permitió adaptar los horarios a nuestro equipo. La formación ha sido práctica, clara y útil para el día a día. Es sencillo de gestionar y los resultados son excepcionales.

Hugo Gutiérrez
Analista Financiero
Gracias a Imagina, la eficiencia de nuestras sesiones de capacitación ha mejorado drásticamente. Es sencillo de usar y los resultados son excepcionales.
Luis Martínez
Administrativo
Gracias al aula virtual de Imagina siempre son capaces de adaptar los cursos a nuestras necesidades. El contenido fue muy completo y práctico.
Elena Pérez
Responsable de Recursos Humanos
Mejor de lo esperado, la modalidad online se adapta a nuestros horarios. La ayuda con la bonificación FUNDAE hizo todo más fácil. Práctico y necesario.
Alejandro Sánchez
Director de Operaciones
Nuestra empresa decidió contratar formación con Imagina aprovechando los créditos de FUNDAE, y fue una gran decisión. La modalidad online nos permitió adaptar los horarios a nuestro equipo. La formación ha sido práctica, clara y útil para el día a día. Es sencillo de gestionar y los resultados son excepcionales.
Hugo Gutiérrez
Analista Financiero
Gracias a Imagina, la eficiencia de nuestras sesiones de capacitación ha mejorado drásticamente. Es sencillo de usar y los resultados son excepcionales.
Luis Martínez
Administrativo
Gracias al aula virtual de Imagina siempre son capaces de adaptar los cursos a nuestras necesidades. El contenido fue muy completo y práctico.
Elena Pérez
Responsable de Recursos Humanos
Mejor de lo esperado, la modalidad online se adapta a nuestros horarios. La ayuda con la bonificación FUNDAE hizo todo más fácil. Práctico y necesario.
Alejandro Sánchez
Director de Operaciones
480.000 alumnos formados en Imagina
Explora las respuestas a las preguntas que guian a nuestra comunidad. Aqui encontraras claridad sobre como funciona todo, desde el acceso hasta los detalles de los cursos. Si buscas respuestas, este es el lugar para comenzar.
No. El curso parte desde los fundamentos de sistemas de información, bases de datos y modelo relacional y desarrolla progresivamente todas las sentencias necesarias.
El contenido es aplicable a los principales SGBD relacionales. El entorno puede basarse en PostgreSQL 18, MySQL 8.4 LTS, SQL Server 2025 o una plataforma equivalente definida para la formación.
Ambas cosas. Se trabaja desde el modelo entidad-relación y la normalización hasta la creación física de tablas y la consulta y manipulación de sus datos.
Se dominan INNER, LEFT, RIGHT, FULL, SELF y CROSS JOIN y las combinaciones entre varias tablas. La optimización de joins sobre grandes volúmenes se reserva para el curso avanzado.
Sí. El alumno aprende subconsultas escalares, multirregistro, EXISTS, NOT EXISTS y conceptos básicos de correlación. Su reescritura y optimización se desarrollan posteriormente.
Se introduce su finalidad y relación con el acceso a los datos, pero índices B-Tree, Hash, GiST, GIN, índices compuestos, parciales y estrategias de indexación pertenecen al curso avanzado.
No de forma deliberada. ROW_NUMBER, RANK, LAG, LEAD, PARTITION BY, CTE y CTE recursivos comienzan en SQL Avanzado y Optimización de Consultas.
Sí. Se trabajan ACID, COMMIT, ROLLBACK, SAVEPOINT y programación almacenada básica para que el alumno llegue preparado al estudio posterior de concurrencia y entornos multiusuario.
El siguiente nivel profundiza en consultas complejas, funciones de ventana, CTE, joins avanzados, índices, planes de ejecución, tuning, particionado, concurrencia, SQL analítico y seguridad.
La formación puede ser bonificable a través de FUNDAE hasta el 100% cuando la empresa dispone de crédito formativo suficiente y se cumplen los requisitos aplicables a la Formación Programada por las Empresas.
¿Tienes dudas?
Estamos aqui para ayudarte
No. El curso parte desde los fundamentos de sistemas de información, bases de datos y modelo relacional y desarrolla progresivamente todas las sentencias necesarias.
¿Tienes dudas?
Estamos aqui para ayudarte
El contenido es aplicable a los principales SGBD relacionales. El entorno puede basarse en PostgreSQL 18, MySQL 8.4 LTS, SQL Server 2025 o una plataforma equivalente definida para la formación.
¿Tienes dudas?
Estamos aqui para ayudarte
Ambas cosas. Se trabaja desde el modelo entidad-relación y la normalización hasta la creación física de tablas y la consulta y manipulación de sus datos.
¿Tienes dudas?
Estamos aqui para ayudarte
Se dominan INNER, LEFT, RIGHT, FULL, SELF y CROSS JOIN y las combinaciones entre varias tablas. La optimización de joins sobre grandes volúmenes se reserva para el curso avanzado.
¿Tienes dudas?
Estamos aqui para ayudarte
Sí. El alumno aprende subconsultas escalares, multirregistro, EXISTS, NOT EXISTS y conceptos básicos de correlación. Su reescritura y optimización se desarrollan posteriormente.
¿Tienes dudas?
Estamos aqui para ayudarte
Se introduce su finalidad y relación con el acceso a los datos, pero índices B-Tree, Hash, GiST, GIN, índices compuestos, parciales y estrategias de indexación pertenecen al curso avanzado.
¿Tienes dudas?
Estamos aqui para ayudarte
No de forma deliberada. ROW_NUMBER, RANK, LAG, LEAD, PARTITION BY, CTE y CTE recursivos comienzan en SQL Avanzado y Optimización de Consultas.
¿Tienes dudas?
Estamos aqui para ayudarte
Sí. Se trabajan ACID, COMMIT, ROLLBACK, SAVEPOINT y programación almacenada básica para que el alumno llegue preparado al estudio posterior de concurrencia y entornos multiusuario.
¿Tienes dudas?
Estamos aqui para ayudarte
El siguiente nivel profundiza en consultas complejas, funciones de ventana, CTE, joins avanzados, índices, planes de ejecución, tuning, particionado, concurrencia, SQL analítico y seguridad.
¿Tienes dudas?
Estamos aqui para ayudarte
La formación puede ser bonificable a través de FUNDAE hasta el 100% cuando la empresa dispone de crédito formativo suficiente y se cumplen los requisitos aplicables a la Formación Programada por las Empresas.
¿Tienes dudas?
Estamos aqui para ayudarte
Descubre Que es Microsoft Power Automate o Microsoft Flow: Guía Completa de la Herramienta de Automatización de Tareas de Microsoft
Descubre cómo instalar Kali Linux fácilmente y empieza a usar esta herramienta esencial para pruebas de penetración y análisis forense digital.
Conoce los cursos bonificados para trabajadores 2025 más demandados y cómo puedes inscribir a tus empleados para aprovechar los créditos formativos de FUNDAE.
Conoce los cursos obligatorios para empresas 2025 y cómo asegurar que tu organización cumpla con las normativas actuales sin riesgos de sanciones.
Descubre los mejores cursos bonificados para empresas en 2025 por la Fundación Tripartita. Aumenta la productividad de tu equipo sin costes adicionales.
Cuéntanos tus objetivos de negocio y prepararemos una propuesta formativa bonificable totalmente ad hoc