Arquitectura interna Scheduler, planes, memoria, stages y tasks permiten comprender la causa real de los problemas en lugar de limitarse a sus síntomas.
1
Totalmente práctico y aplicable
Formación en Spark Avanzado a medida
100% bonificable a través de FUNDAE
Curso TUTORIZADO por expertos


Curso de Spark Avanzado en Aula Virtual Personalizada
Nuestra modalidad AVP es una formación en directo, práctica y 100% adaptada a vuestro equipo. No trabajamos con contenidos genéricos: diseñamos la formación en función de vuestro nivel, objetivos, procesos internos y necesidades reales de aplicación.
Solicitar información
Temario 100% a medida
Creamos el temario desde cero a partir de vuestras necesidades, nivel del equipo y objetivos concretos, priorizando aquellos contenidos que realmente aporten valor en el día a día.
Proyectos personalizados
Durante la formación trabajaremos con archivos, ejemplos, informes o procesos similares a los que utiliza vuestro equipo, para que el aprendizaje sea directamente aplicable al puesto de trabajo.
Sesiones en directo con consultor experto
Un formador especialista imparte las clases en tiempo real, resolviendo dudas, revisando casos concretos y adaptando el ritmo de la formación a la evolución del grupo.
Calendario adaptado a vuestra disponibilidad
Definimos conjuntamente fechas, horarios y duración de las sesiones para facilitar la asistencia del equipo y minimizar el impacto en la operativa diaria de la empresa.
Forma a tu equipo sin costes mediante la bonificación estatal.
Este programa de Spark Avanzado para empresas es subvencionable hasta el 100%.
Calcula tu bonificación
Revisamos tu caso
Preparamos la gestión
Tu equipo realiza el curso
Aplicas la bonificación
Todos nuestros cursos son bonificables a través de FUNDAE.
Gestionamos toda la documentación por ti.
Calcula tu crédito aproximado
Crédito bonificable estimado
420€*
*Cálculo orientativo
Acelera la adopción de Spark en tu equipo con un curso A Medida en streaming y rendimiento, tutorizado y bonificable por FUNDAE para empresas. Contáctanos.
Diseñamos una formación a medida utilizando los documentos y flujos de trabajo reales de tu empresa.

Los alumnos podrán revisar las sesiones grabadas para repasar conceptos clave, recuperar explicaciones concretas o reforzar aquellos contenidos que necesiten después de la clase en directo.

Materiales, sesiones grabadas y documentación de apoyo quedan centralizados en la plataforma para que el equipo pueda consultarlos durante y después de la formación.

La plataforma permite registrar y confirmar la asistencia de los participantes, facilitando el seguimiento de la formación y la gestión documental necesaria para la bonificación FUNDAE.

Después de la formación en directo, los alumnos podrán acceder a ejercicios prácticos para aplicar lo trabajado en clase y consolidar el aprendizaje con actividades guiadas.
Los alumnos podrán revisar las sesiones grabadas para repasar conceptos clave, recuperar explicaciones concretas o reforzar aquellos contenidos que necesiten después de la clase en directo.
Materiales, sesiones grabadas y documentación de apoyo quedan centralizados en la plataforma para que el equipo pueda consultarlos durante y después de la formación.
La plataforma permite registrar y confirmar la asistencia de los participantes, facilitando el seguimiento de la formación y la gestión documental necesaria para la bonificación FUNDAE.
Después de la formación en directo, los alumnos podrán acceder a ejercicios prácticos para aplicar lo trabajado en clase y consolidar el aprendizaje con actividades guiadas.
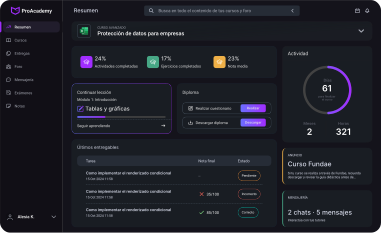
Una plataforma practica, con IA integrada y pensada para que mejores desarrollando. Se adapta a tu ritmo, te corrige al instante y te muestra tu progreso real.
Correccion magica
Feedback inteligente

Aprende de cada acierto y fallo con explicaciones claras
Encuentra todo el temario del curso aquí.

Evolución desde el modelo conceptual driver/executor hasta el análisis detallado de una aplicación distribuida.
SparkSession, SparkContext, DAG Scheduler, Task Scheduler y Backends como componentes que intervienen en la ejecución.
Transformación de una acción de usuario en Job, Stages y Tasks distribuidas.
Narrow dependencies frente a wide dependencies y consecuencias sobre pipelining y shuffle.
Stage boundaries creadas por Exchanges y otras operaciones que requieren redistribución.
Locality levels y relación entre localización del dato, red y planificación de tasks.
Task retries y comportamiento frente a fallos de executors o particiones concretas.
Speculative execution para mitigar stragglers y situaciones donde puede resultar contraproducente.
Job groups, cancellation y control de trabajos desde aplicaciones de larga duración.
Scheduler FIFO frente a FAIR y utilización de pools para compartir recursos entre trabajos concurrentes.
Ejecución concurrente de varios Jobs dentro del mismo SparkContext.
Barrier Execution Mode y workloads que necesitan coordinación entre tasks.
Diferencia entre cuello de botella del scheduler y cuello de botella producido por CPU, memoria, red o almacenamiento.
Relación entre arquitectura interna y síntomas observables en Spark UI.
Metodología de diagnóstico desde una aplicación lenta hasta la etapa concreta responsable del problema.
Catalyst Optimizer como framework encargado de analizar y transformar consultas estructuradas.
Parsed Logical Plan, Analyzed Logical Plan, Optimized Logical Plan y Physical Plan.
Resolución de nombres, tipos y expresiones durante la fase de análisis.
Constant folding, predicate pushdown, column pruning y simplificación de expresiones.
Cost-Based Optimization y utilización de estadísticas para elegir planes más eficientes.
`ANALYZE TABLE`, estadísticas de tablas y columnas y consecuencias de disponer de información obsoleta.
`EXPLAIN`, `EXPLAIN FORMATTED`, `EXPLAIN COST` y `DataFrame.explain()` como herramientas de diagnóstico.
Selección física entre Broadcast Hash Join, Sort Merge Join, Shuffled Hash Join y Nested Loop Join.
Join hints `BROADCAST`, `MERGE`, `SHUFFLE_HASH` y `SHUFFLE_REPLICATE_NL`.
Adaptive Query Execution como reoptimización del plan utilizando estadísticas obtenidas durante la propia ejecución.
Coalescing dinámico de particiones después del shuffle.
Conversión adaptativa de Sort Merge Join hacia Broadcast Hash Join o Shuffled Hash Join.
Optimización automática de skew joins mediante particiones desequilibradas detectadas en runtime.
Custom Cost Evaluator y exclusión selectiva de reglas de AQE en escenarios especializados.
Storage Partition Join para aprovechar layouts compatibles de Data Source V2 y evitar shuffles completos.
Partición como unidad de trabajo y paralelismo y diferencias entre particionamiento lógico y físico.
Número de particiones frente a número de cores y capacidad efectiva del clúster.
`spark.sql.shuffle.partitions` y relación con joins, agregaciones y otras operaciones de intercambio.
`repartition`, `repartitionByRange`, `coalesce` y `REBALANCE` y selección según el objetivo.
Hash partitioning frente a range partitioning.
Cómo detectar un shuffle desde el plan físico mediante operadores Exchange.
Costes de shuffle: serialización, escritura local, transferencia de red, lectura y merge.
Spill a disco y relación con presión de memoria.
Data skew producido por claves de frecuencia muy desigual.
Identificación de skew mediante duración de tasks, shuffle read y tamaños de partición.
AQE skew optimization frente a técnicas manuales como salting.
Small files problem y coste de listar, abrir y planificar grandes cantidades de archivos.
`spark.sql.files.maxPartitionBytes`, open cost y control del número de particiones de lectura.
Coalesce y Repartition hints para controlar el número de archivos resultante.
Diseño conjunto de particionado de almacenamiento y ejecución para reducir movimiento de datos.
Arquitectura de memoria del executor y diferencia entre ejecución, almacenamiento y overhead.
Unified Memory Management y competencia entre almacenamiento en caché y estructuras utilizadas durante ejecución.
Heap frente a memoria off-heap.
Memoria del driver y riesgos de `collect`, `toPandas`, grandes broadcasts y metadata excesiva.
`spark.executor.memory`, `spark.executor.memoryOverhead`, cores y número de executors.
Relación entre demasiados cores por executor, garbage collection y aislamiento de fallos.
Serialización Java frente a Kryo en workloads compatibles.
Coste de serializar closures y objetos enviados a executors.
Garbage Collection y análisis de pausas, allocation rate y objetos temporales.
Spills de memoria a disco como síntoma y no necesariamente como causa primaria.
Caching mediante MEMORY_ONLY, MEMORY_AND_DISK y otros Storage Levels.
Cuándo persistir, qué materializar y cuándo llamar a `unpersist`.
Broadcast variables para datos reutilizados de solo lectura.
Resource Profiles para asignar diferentes recursos a fases o workloads especializados.
CPU, memoria, GPU y otros recursos como dimensiones independientes que deben dimensionarse según el perfil de cada aplicación.
Coste histórico de cruzar la frontera JVM-Python y evolución del modelo de ejecución de PySpark.
Apache Arrow como formato columnar para intercambiar datos con menor overhead.
Arrow-optimized Python UDF habilitadas por defecto en la rama actual de Spark.
Diferencias entre Python UDF convencional, Pandas UDF y Arrow UDF.
Scalar, grouped aggregation, grouped map e iterator-based Pandas UDF según la operación.
UDTF para devolver múltiples filas a partir de una invocación.
Priorización de funciones nativas SQL antes de recurrir a UDF.
Vectorización y procesamiento por lotes frente a ejecución fila a fila.
Integración PySpark-pandas mediante Arrow.
Pandas API on Spark para migrar determinados workloads sin perder procesamiento distribuido.
Cuándo pandas local sigue siendo más adecuado que Spark.
Broadcast de modelos o estructuras auxiliares utilizados desde funciones Python.
Dependencias Python en executors y estrategias para distribuir entornos reproducibles.
Profiling de UDF y localización de hotspots Python.
Separación entre optimización del plan Spark y optimización del código ejecutado dentro de cada task Python.
ANSI SQL como base para escribir consultas más predecibles y detectar errores que antes podían producir conversiones silenciosas.
CTE, subqueries correlacionadas, Window Functions, PIVOT y operaciones analíticas complejas.
SQL Scripting para combinar variables, bloques, cursores, condicionales y control de flujo en procedimientos analíticos.
Pipe syntax para construir transformaciones SQL de lectura secuencial.
Path-based name resolution mediante `SET PATH` y `CURRENT_PATH()`.
Metric Views para definir métricas reutilizables y una capa semántica declarativa.
Change Data Capture mediante la cláusula `CHANGES` y sus APIs DataFrame equivalentes.
Consultas batch y streaming sobre cambios de filas proporcionados por fuentes compatibles.
`QUALIFY` aplicado al filtrado posterior a funciones ventana.
`INSERT ... WITH SCHEMA EVOLUTION` para fuentes Data Source V2 compatibles.
Tipos `GEOMETRY` y `GEOGRAPHY` y funciones `ST_*` para procesamiento geoespacial nativo.
WKT, WKB, SRID y almacenamiento Parquet de información geoespacial.
`NEAREST BY` para consultas top-K de proximidad dentro del motor.
Funciones vectoriales y sketches aplicadas a análisis de datos de gran escala.
Collations, tipos temporales y evolución del sistema de tipos para workloads internacionales y analíticos complejos.
Data Source V2 como arquitectura moderna de integración entre Spark y sistemas de almacenamiento.
Separación entre TableProvider, CatalogPlugin, TableCatalog, SupportsRead y SupportsWrite.
Catalogs personalizados para acceder a diferentes sistemas mediante namespaces y tablas.
Diferencias entre Session Catalog, catálogos V2 y metastore externo.
Pushdown de filtros hacia la fuente.
Column pruning para recuperar únicamente atributos necesarios.
Aggregate pushdown y otras optimizaciones cuando el datasource las implementa.
Partition pruning basado en información proporcionada por la fuente.
Partition statistics filtering incorporado a las capacidades actuales de Data Source V2.
Schema evolution durante operaciones `INSERT` en datasources compatibles.
Row-level operations para operaciones de modificación soportadas por determinados conectores.
Transaction management para agrupar operaciones soportadas de forma atómica dentro de Data Source V2.
Changelog y capacidades CDC expuestas por una fuente.
Métricas proporcionadas por conectores y su integración con observabilidad.
Diseño de un datasource propio cuando JDBC, archivos o conectores existentes no cubren la necesidad del sistema.
Spark Connect como arquitectura desacoplada entre aplicación cliente y servidor Spark.
Logical plans no resueltos como protocolo independiente del lenguaje entre cliente y servidor.
Protocol Buffers y gRPC como mecanismos utilizados para transportar operaciones.
Apache Arrow para transmitir resultados desde el servidor hacia el cliente.
Diferencias entre Spark Connect y aplicaciones clásicas que ejecutan código junto al driver.
Ausencia de acceso directo al JVM del driver desde clientes PySpark Connect.
Limitaciones sobre SparkContext y APIs RDD en el modelo Connect.
PySpark y Scala como clientes oficiales y soporte progresivo de las APIs DataFrame.
Session isolation para múltiples clientes conectados al mismo servidor.
Separación de dependencias del cliente respecto al proceso del driver.
Independencia de actualización entre aplicaciones cliente y Spark Server.
Depuración desde IDE sin necesidad de ejecutar la aplicación en el mismo proceso del driver.
Streaming mediante las APIs soportadas por Spark Connect.
Autenticación mediante infraestructura externa y proxies frente a ausencia de autenticación incorporada directamente por Connect.
Arquitectura Spark Connect como base para notebooks, aplicaciones web, servicios de datos y plataformas multiusuario.
Structured Streaming como ejecución incremental de planes basados en DataFrame y Spark SQL.
Event time frente a processing time y consecuencias sobre consistencia temporal.
Watermarks y definición del límite de datos tardíos que debe conservar el sistema.
Stream-stream joins y crecimiento del estado.
Agregaciones stateful con ventanas temporales.
Checkpoints como combinación de offsets, commits, metadata y estado persistido.
Compatibilidad de cambios de aplicación con checkpoints ya existentes.
`TransformWithState` como API de nueva generación para procesamiento stateful arbitrario.
StatefulProcessor como encapsulación de la lógica de estado.
ValueState, ListState y MapState.
TTL automático para eliminar información expirada.
Timers de processing time y event time.
Initial State para precargar información antes de procesar el stream.
Evolución de schema del estado y sus limitaciones.
Real-Time Mode como trigger de baja latencia disponible también desde PySpark en la rama actual.
Semánticas end-to-end y diferencia entre exactly-once processing y exactly-once delivery.
Relación entre garantías del source, motor Spark y sink utilizado.
Offset management y recuperación después de la caída del driver.
Commit logs y coordinación con sistemas externos.
Idempotencia cuando un sink no dispone de una transacción exactamente una vez.
`foreachBatch` para integrar lógica batch dentro de cada micro-batch.
Deduplicación stateful con event time.
State Store y proveedores basados en HDFS o RocksDB.
Detección de corrupción mediante checksums del state store en capacidades actuales de Spark.
Reparación automática de snapshots y consistencia de metadata de checkpoint.
Naming estable de streaming sources para poder añadir, eliminar o reordenar fuentes sin romper checkpoints en escenarios compatibles.
Sink naming y persistencia de identidad dentro del commit log.
Trigger AvailableNow para procesar el backlog disponible y detener posteriormente la consulta.
Admission Control para fuentes capaces de limitar la cantidad de información procesada por trigger.
Métricas operativas para controlar input rate, processed rows, estado, duración de batches y retraso acumulado.
Spark Declarative Pipelines como framework nativo para expresar qué datasets deben existir y no únicamente cómo ejecutar cada job.
Pipelines formados por datasets, flows, fuentes y sinks.
Materialized Views para resultados batch mantenidos por el pipeline.
Streaming Tables para conjuntos actualizados incrementalmente.
Temporary Views para transformaciones intermedias.
Dependencias inferidas automáticamente a partir de las referencias entre datasets.
Definición de pipelines mediante Python.
Decoradores de `pyspark.pipelines` para registrar datasets.
Definición mediante SQL utilizando `CREATE MATERIALIZED VIEW` y `CREATE STREAMING TABLE`.
Multiple Flows escribiendo sobre un mismo target cuando el diseño lo requiere.
Sinks para enviar resultados a sistemas externos además de tablas y vistas administradas por el pipeline.
Auto CDC para construir flujos SCD Type 1 de forma declarativa en fuentes compatibles.
Full Refresh frente a actualización incremental selectiva.
Validación del grafo mediante dry run antes de ejecutar el pipeline.
Integración entre Declarative Pipelines, Structured Streaming, Spark Connect y Data Source V2 en arquitecturas modernas.
Diferencia entre formato de archivo como Parquet y formato de tabla que añade metadata, snapshots y operaciones transaccionales.
Spark como motor compatible mediante conectores con formatos de tabla modernos.
Apache Iceberg como ejemplo de Data Source V2 capaz de exponer particionamiento al optimizador.
Integración con Apache Hudi o Delta Lake cuando forman parte de la plataforma seleccionada.
Catalogs como capa de resolución entre Spark y tablas gestionadas por sistemas externos.
Hidden partitioning y partition evolution cuando el formato utilizado lo soporta.
Schema evolution y compatibilidad con readers existentes.
Time travel y snapshots como funcionalidades proporcionadas por determinados formatos de tabla, no por Parquet aislado.
Change Data Capture y changelog como patrón para procesamiento incremental.
MERGE, UPDATE y DELETE dependiendo de las capacidades declaradas por el datasource.
Storage Partition Join aprovechando distribución física de fuentes V2 compatibles para eliminar Exchange.
Object storage y diferencias respecto a sistemas de archivos tradicionales.
Problemas derivados de millones de archivos pequeños y necesidad de estrategias de compactación.
Metadata planning como coste relevante en tablas de escala extrema.
Separación conceptual entre motor Spark, catálogo, formato de tabla y sistema físico de almacenamiento.
Selección entre Standalone, YARN y Kubernetes según infraestructura, gobierno y cargas coexistentes.
Driver en client mode frente a cluster mode.
Dynamic Allocation para ajustar executors según backlog y necesidades de la aplicación.
External Shuffle Service frente a shuffle tracking según el cluster manager.
Dynamic Allocation en Kubernetes mediante shuffle tracking al no existir External Shuffle Service nativo.
Executor allocation inicial, mínimo y máximo.
Resource Profiles para stages con necesidades distintas.
Executors heterogéneos en Kubernetes dentro de escenarios compatibles.
Pod templates para definir containers, volumes, tolerations, labels y configuración corporativa.
Persistent Volumes para shuffle u otros datos temporales cuando el diseño lo exige.
Node selectors, affinity y scheduling sobre diferentes pools de nodos.
Kubernetes secrets y ConfigMaps para configuración sensible o externalizada.
FAIR Scheduler para compartir recursos entre Jobs concurrentes dentro de una aplicación.
Multi-tenancy, quotas y límites de recursos para evitar que una carga monopolice el clúster.
Capacidad, elasticidad y coste como parte conjunta del dimensionamiento productivo.
Spark Web UI como representación visual de la ejecución real y no únicamente como herramienta de monitorización superficial.
Análisis comparativo de Jobs, Stages, Tasks, Executors, Storage y SQL.
Visualización actual de planes SQL para comparar estructura lógica y física de consultas.
Spark History Server para investigación posterior utilizando Event Logs.
Rolling event logs y estrategias para evitar crecimiento ilimitado del almacenamiento histórico.
REST API `/api/v1` para obtener métricas de aplicaciones activas y finalizadas programáticamente.
Task Metrics para analizar executor run time, shuffle, input, output, spills y otros indicadores.
Executor Metrics para memoria JVM, garbage collection y utilización de recursos.
Prometheus endpoints integrados para exponer métricas de driver, executors, master y workers.
Metrics System y sinks configurables para herramientas corporativas.
StreamingQueryListener para recopilar eventos y progreso de consultas streaming.
SparkListener para desarrollar instrumentación específica sobre eventos del scheduler.
Correlación de Spark metrics con Kubernetes, YARN, almacenamiento, JVM y red.
Diagnóstico de stragglers, skew, executor loss, fetch failures, OOM, GC excesivo y timeouts.
Construcción de runbooks que relacionen cada síntoma operativo con las evidencias que deben inspeccionarse.
Separación de transformaciones puras para facilitar unit testing sin arrancar un clúster completo.
Integration tests mediante SparkSession local con datasets pequeños y deterministas.
Comparación de DataFrames por schema, contenido, nullability y orden cuando resulte relevante.
Golden datasets y expected outputs para detectar regresiones complejas.
Tests específicos de `TransformWithState` mediante herramientas como TwsTester.
Testing de recuperación desde checkpoints y fallos simulados en aplicaciones streaming.
Contract testing entre productores, tablas y consumidores.
Validación de pipelines antes de desplegar mediante dry run.
Empaquetado reproducible de Python y JVM dependencies.
CI/CD para ejecutar análisis estático, tests, packaging y validación del artefacto Spark.
Configuración externa por entorno frente a valores hardcoded dentro de la aplicación.
Autenticación, autorización, ACL, TLS, network security y secrets dentro de una plataforma Spark productiva.
Revisión de migration guides antes de actualizar entre ramas mayores y menores.
Compatibilidad de código, connectors, catalogs y checkpoints antes de realizar un upgrade.
Estrategias blue/green, canary o ejecución paralela cuando una migración de Spark presenta riesgo operativo elevado.
Arquitectura avanzada de una plataforma Spark que combine batch, streaming, SQL y procesamiento incremental.
Definición de objetivos de rendimiento, latencia, throughput, disponibilidad y recuperación.
Modelo de ejecución esperado mediante Jobs, Stages, Tasks y recursos.
Identificación de operaciones que generan shuffle y estimación de su impacto.
Estrategia de particionamiento y distribución física del dato.
Configuración de estadísticas para mejorar la planificación de Catalyst.
Uso de Adaptive Query Execution y criterios para validar su comportamiento.
Selección justificada de estrategias de join y posibles hints.
Tratamiento de data skew y particiones descompensadas.
Estrategia de caching y persistencia basada en reutilización real.
Dimensionamiento de driver, executors, memory overhead y cores.
Diseño PySpark que minimice overhead y priorice funciones nativas o Arrow.
Capa SQL avanzada con CDC, Window Functions y funcionalidades analíticas.
Integración con un catálogo y Data Source V2.
Arquitectura Spark Connect para separar aplicaciones clientes del entorno de ejecución.
Componente Structured Streaming con watermarks y procesamiento stateful.
Modelo `TransformWithState` con state variables, timers y TTL.
Estrategia de checkpointing y recuperación después de fallos.
Pipeline declarativo que integre Streaming Tables, Materialized Views y flows.
Flujo CDC para incorporar cambios procedentes de una fuente operacional.
Diseño de almacenamiento basado en Parquet y un formato de tabla compatible.
Evaluación de Storage Partition Join para reducir shuffles.
Estrategia de despliegue en Kubernetes o YARN.
Dynamic Allocation y límites mínimos y máximos de recursos.
Modelo de aislamiento y seguridad de aplicación.
Event Logging, History Server y REST API de observabilidad.
Métricas exportadas a Prometheus y dashboard operacional.
Runbooks para skew, executor loss, memory pressure y fetch failures.
Pipeline CI/CD con testing, packaging y validación de configuración.
Estrategia de actualización de Spark y conectores sin interrumpir workloads críticos.
Análisis de coste frente a rendimiento para diferentes configuraciones de recursos.
Criterios de rollback cuando una optimización degrada rendimiento o estabilidad.
Documentación de decisiones arquitectónicas y configuraciones críticas.
Matriz de riesgos de datos, ejecución, infraestructura y dependencias.
Modelo final de operación continua basado en medición, ajuste y evolución controlada.
Senior Data Engineers
Profesionales que desarrollan pipelines Spark y necesitan profundizar en rendimiento, streaming, CDC y arquitectura.
Senior PySpark Developers
Perfiles que quieren optimizar la frontera Python-JVM, utilizar Arrow y diagnosticar correctamente aplicaciones PySpark.
Big Data Developers
Desarrolladores responsables de aplicaciones distribuidas complejas y cargas de elevado volumen.
Data Architects
Profesionales que diseñan plataformas Spark, lakehouse, catálogos, formatos de tabla y modelos de procesamiento.
Streaming Engineers
Especialistas que necesitan construir procesamiento stateful, tolerante a fallos y de baja latencia.
Platform Engineers
Profesionales responsables de Kubernetes, YARN, recursos, seguridad y observabilidad.
DevOps Engineers
Perfiles encargados de CI/CD, packaging, configuración, despliegue y operación de aplicaciones Spark.
Performance Engineers
Especialistas que necesitan diagnosticar problemas de CPU, memoria, shuffle, red y almacenamiento.
Arquitectos Cloud
Profesionales que diseñan plataformas elásticas y optimizan la relación entre capacidad, rendimiento y coste.
Administradores de Plataformas de Datos
Perfiles responsables de disponibilidad, seguridad, multi-tenancy, actualización y operación continuada.
Experiencias reales de equipos que ya han trabajado con nosotros.
+16
años de liderazgo
+3.500
empresas formadas
Nuestra empresa decidió contratar formación con Imagina aprovechando los créditos de FUNDAE, y fue una gran decisión. La modalidad online nos permitió adaptar los horarios a nuestro equipo. La formación ha sido práctica, clara y útil para el día a día. Es sencillo de gestionar y los resultados son excepcionales.

Hugo Gutiérrez
Analista Financiero
Gracias a Imagina, la eficiencia de nuestras sesiones de capacitación ha mejorado drásticamente. Es sencillo de usar y los resultados son excepcionales.
Luis Martínez
Administrativo
Gracias al aula virtual de Imagina siempre son capaces de adaptar los cursos a nuestras necesidades. El contenido fue muy completo y práctico.
Elena Pérez
Responsable de Recursos Humanos
Mejor de lo esperado, la modalidad online se adapta a nuestros horarios. La ayuda con la bonificación FUNDAE hizo todo más fácil. Práctico y necesario.
Alejandro Sánchez
Director de Operaciones
Nuestra empresa decidió contratar formación con Imagina aprovechando los créditos de FUNDAE, y fue una gran decisión. La modalidad online nos permitió adaptar los horarios a nuestro equipo. La formación ha sido práctica, clara y útil para el día a día. Es sencillo de gestionar y los resultados son excepcionales.
Hugo Gutiérrez
Analista Financiero
Gracias a Imagina, la eficiencia de nuestras sesiones de capacitación ha mejorado drásticamente. Es sencillo de usar y los resultados son excepcionales.
Luis Martínez
Administrativo
Gracias al aula virtual de Imagina siempre son capaces de adaptar los cursos a nuestras necesidades. El contenido fue muy completo y práctico.
Elena Pérez
Responsable de Recursos Humanos
Mejor de lo esperado, la modalidad online se adapta a nuestros horarios. La ayuda con la bonificación FUNDAE hizo todo más fácil. Práctico y necesario.
Alejandro Sánchez
Director de Operaciones
480.000 alumnos formados en Imagina
Explora las respuestas a las preguntas que guian a nuestra comunidad. Aqui encontraras claridad sobre como funciona todo, desde el acceso hasta los detalles de los cursos. Si buscas respuestas, este es el lugar para comenzar.
Está diseñado como continuación directa. También puede acceder un profesional que ya domine DataFrames, Spark SQL, Structured Streaming, particiones y despliegue.
Sí. Catalyst, estadísticas, AQE, joins, shuffles, skew, particiones, memoria, caching, Arrow y almacenamiento constituyen una parte central del programa.
Sí. Incluye TransformWithState, TTL, timers, state stores, checkpoints, watermarks, stream-stream joins y Real-Time Mode.
Sí. Spark dispone actualmente de `CHANGES` y APIs CDC en DataFrame/PySpark, además de Auto CDC para SCD Type 1 dentro de Declarative Pipelines.
Sí. Se estudian protocolo, gRPC, Arrow, sesiones, aislamiento, limitaciones y diseño de aplicaciones cliente-servidor.
Sí. Se utilizan como ejemplo de integración mediante Data Source V2 y de optimizaciones como Storage Partition Join, sin convertir el curso en una formación específica de un único formato.
Sí. Incluye pods, recursos, volumes, Dynamic Allocation, shuffle tracking, Resource Profiles y operación de aplicaciones Spark.
Sí. Spark expone métricas mediante endpoints Prometheus y REST que pueden integrarse con una plataforma corporativa de observabilidad.
Sí. El programa incorpora Spark 4.2, incluida su evolución en CDC, Data Source V2, Spark Connect, PySpark, geospatial, streaming y observabilidad.
La formación puede ser bonificable a través de FUNDAE hasta el 100% cuando la empresa dispone de crédito suficiente y se cumplen los requisitos aplicables a la Formación Programada por las Empresas.
¿Tienes dudas?
Estamos aqui para ayudarte
Está diseñado como continuación directa. También puede acceder un profesional que ya domine DataFrames, Spark SQL, Structured Streaming, particiones y despliegue.
¿Tienes dudas?
Estamos aqui para ayudarte
Sí. Catalyst, estadísticas, AQE, joins, shuffles, skew, particiones, memoria, caching, Arrow y almacenamiento constituyen una parte central del programa.
¿Tienes dudas?
Estamos aqui para ayudarte
Sí. Incluye TransformWithState, TTL, timers, state stores, checkpoints, watermarks, stream-stream joins y Real-Time Mode.
¿Tienes dudas?
Estamos aqui para ayudarte
Sí. Spark dispone actualmente de `CHANGES` y APIs CDC en DataFrame/PySpark, además de Auto CDC para SCD Type 1 dentro de Declarative Pipelines.
¿Tienes dudas?
Estamos aqui para ayudarte
Sí. Se estudian protocolo, gRPC, Arrow, sesiones, aislamiento, limitaciones y diseño de aplicaciones cliente-servidor.
¿Tienes dudas?
Estamos aqui para ayudarte
Sí. Se utilizan como ejemplo de integración mediante Data Source V2 y de optimizaciones como Storage Partition Join, sin convertir el curso en una formación específica de un único formato.
¿Tienes dudas?
Estamos aqui para ayudarte
Sí. Incluye pods, recursos, volumes, Dynamic Allocation, shuffle tracking, Resource Profiles y operación de aplicaciones Spark.
¿Tienes dudas?
Estamos aqui para ayudarte
Sí. Spark expone métricas mediante endpoints Prometheus y REST que pueden integrarse con una plataforma corporativa de observabilidad.
¿Tienes dudas?
Estamos aqui para ayudarte
Sí. El programa incorpora Spark 4.2, incluida su evolución en CDC, Data Source V2, Spark Connect, PySpark, geospatial, streaming y observabilidad.
¿Tienes dudas?
Estamos aqui para ayudarte
La formación puede ser bonificable a través de FUNDAE hasta el 100% cuando la empresa dispone de crédito suficiente y se cumplen los requisitos aplicables a la Formación Programada por las Empresas.
¿Tienes dudas?
Estamos aqui para ayudarte
Descubre Que es Microsoft Power Automate o Microsoft Flow: Guía Completa de la Herramienta de Automatización de Tareas de Microsoft
Descubre cómo instalar Kali Linux fácilmente y empieza a usar esta herramienta esencial para pruebas de penetración y análisis forense digital.
Conoce los cursos bonificados para trabajadores 2025 más demandados y cómo puedes inscribir a tus empleados para aprovechar los créditos formativos de FUNDAE.
Conoce los cursos obligatorios para empresas 2025 y cómo asegurar que tu organización cumpla con las normativas actuales sin riesgos de sanciones.
Descubre los mejores cursos bonificados para empresas en 2025 por la Fundación Tripartita. Aumenta la productividad de tu equipo sin costes adicionales.
Cuéntanos tus objetivos de negocio y prepararemos una propuesta formativa bonificable totalmente ad hoc