Kubernetes-native KServe se trabaja mediante CRD y recursos Kubernetes reales, evitando esconder el funcionamiento de la infraestructura subyacente.
1
Totalmente práctico y aplicable
Formación en KServe a medida
100% bonificable a través de FUNDAE
Curso TUTORIZADO por expertos


Curso de KServe en Aula Virtual Personalizada
Nuestra modalidad AVP es una formación en directo, práctica y 100% adaptada a vuestro equipo. No trabajamos con contenidos genéricos: diseñamos la formación en función de vuestro nivel, objetivos, procesos internos y necesidades reales de aplicación.
Solicitar información
Temario 100% a medida
Creamos el temario desde cero a partir de vuestras necesidades, nivel del equipo y objetivos concretos, priorizando aquellos contenidos que realmente aporten valor en el día a día.
Proyectos personalizados
Durante la formación trabajaremos con archivos, ejemplos, informes o procesos similares a los que utiliza vuestro equipo, para que el aprendizaje sea directamente aplicable al puesto de trabajo.
Sesiones en directo con consultor experto
Un formador especialista imparte las clases en tiempo real, resolviendo dudas, revisando casos concretos y adaptando el ritmo de la formación a la evolución del grupo.
Calendario adaptado a vuestra disponibilidad
Definimos conjuntamente fechas, horarios y duración de las sesiones para facilitar la asistencia del equipo y minimizar el impacto en la operativa diaria de la empresa.
Forma a tu equipo sin costes mediante la bonificación estatal.
Este programa de KServe para empresas es subvencionable hasta el 100%.
Calcula tu bonificación
Revisamos tu caso
Preparamos la gestión
Tu equipo realiza el curso
Aplicas la bonificación
Todos nuestros cursos son bonificables a través de FUNDAE.
Gestionamos toda la documentación por ti.
Calcula tu crédito aproximado
Crédito bonificable estimado
420€*
*Cálculo orientativo
Diseñamos una formación a medida utilizando los documentos y flujos de trabajo reales de tu empresa.

Los alumnos podrán revisar las sesiones grabadas para repasar conceptos clave, recuperar explicaciones concretas o reforzar aquellos contenidos que necesiten después de la clase en directo.

Materiales, sesiones grabadas y documentación de apoyo quedan centralizados en la plataforma para que el equipo pueda consultarlos durante y después de la formación.

La plataforma permite registrar y confirmar la asistencia de los participantes, facilitando el seguimiento de la formación y la gestión documental necesaria para la bonificación FUNDAE.

Después de la formación en directo, los alumnos podrán acceder a ejercicios prácticos para aplicar lo trabajado en clase y consolidar el aprendizaje con actividades guiadas.
Los alumnos podrán revisar las sesiones grabadas para repasar conceptos clave, recuperar explicaciones concretas o reforzar aquellos contenidos que necesiten después de la clase en directo.
Materiales, sesiones grabadas y documentación de apoyo quedan centralizados en la plataforma para que el equipo pueda consultarlos durante y después de la formación.
La plataforma permite registrar y confirmar la asistencia de los participantes, facilitando el seguimiento de la formación y la gestión documental necesaria para la bonificación FUNDAE.
Después de la formación en directo, los alumnos podrán acceder a ejercicios prácticos para aplicar lo trabajado en clase y consolidar el aprendizaje con actividades guiadas.
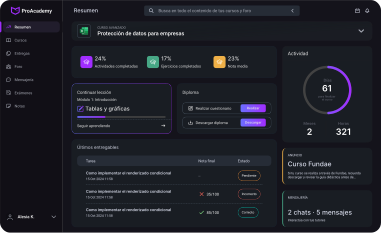
Una plataforma practica, con IA integrada y pensada para que mejores desarrollando. Se adapta a tu ritmo, te corrige al instante y te muestra tu progreso real.
Correccion magica
Feedback inteligente

Aprende de cada acierto y fallo con explicaciones claras
Encuentra todo el temario del curso aquí.

¿Qué es Model Serving y qué problemas aparecen al pasar de un modelo entrenado a un servicio de inferencia productivo?
¿Qué es KServe y qué aporta sobre un Deployment Kubernetes creado manualmente?
KServe como plataforma Kubernetes-native para servir modelos predictivos y cargas de Inteligencia Artificial Generativa.
Relación entre Data Scientist, ML Engineer, MLOps Engineer, Platform Engineer y equipos consumidores de los endpoints.
Separación entre entrenamiento del modelo y serving de inferencia.
Diferencias entre batch inference, online inference, streaming inference y servicios de IA generativa.
Control Plane y Data Plane como capas diferenciadas de gestión y ejecución de inferencias.
`InferenceService` como recurso principal para modelos predictivos y escenarios generativos estándar.
`LLMInferenceService` como recurso especializado para cargas LLM que requieren capacidades avanzadas de routing, scheduling y distribución.
Predictor, Transformer y Explainer como componentes tradicionales del Data Plane.
ServingRuntime, almacenamiento, networking, autoscaling y observabilidad como piezas de una arquitectura completa.
Relación de KServe con Kubernetes, Kubeflow, MLflow, registries de modelos, gateways y plataformas MLOps.
Casos de uso: clasificación, regresión, NLP, visión, forecasting, embeddings, reranking y Large Language Models.
Criterios para decidir cuándo KServe aporta valor y cuándo un servicio de inferencia más sencillo resulta suficiente.
Componentes instalables de KServe y separación entre controlador principal, LLMInferenceService y Local Model Cache.
Instalación mediante Helm, Kustomize y manifiestos Kubernetes.
Custom Resource Definitions utilizadas para representar servicios y runtimes de inferencia.
Standard Mode basado en Deployment, Service, networking Kubernetes y HorizontalPodAutoscaler.
Knative Mode para escenarios serverless con capacidades específicas de escalado impulsado por peticiones.
Comparación entre Standard y Knative según control de recursos, dependencias, cold starts y comportamiento esperado.
Standard Mode como enfoque especialmente apropiado para cargas GPU y generación de larga duración.
Gateway API como opción recomendada actualmente para exposición de servicios, manteniéndose soporte de Ingress.
GatewayClass, Gateway, HTTPRoute e integración con controladores de red.
cert-manager y certificados utilizados por webhooks y componentes internos.
ConfigMaps principales de KServe y parámetros de configuración global.
Instalación y verificación de los ClusterServingRuntimes predeterminados.
Namespaces, service accounts y permisos administrativos durante el aprovisionamiento.
Validación de la instalación mediante CRD, Pods, eventos, logs y recursos generados.
Anatomía del recurso `InferenceService` y campos fundamentales de su especificación.
Declaración del predictor y referencia al formato de modelo.
`storageUri` como ubicación del artefacto que debe cargarse durante el arranque.
Selección explícita o automática del ServingRuntime.
`runtimeVersion` para fijar una versión concreta del runtime en entornos productivos.
Requests y limits de CPU, memoria y aceleradores.
Variables de entorno, argumentos y configuración específica del modelo.
Readiness y liveness como condiciones distintas dentro del ciclo de vida.
Estado de `InferenceService`, Conditions y diagnóstico de recursos no preparados.
URL interna y externa generada para el servicio.
Actualización de la especificación y reconciliación automática por parte del controlador.
Diferencia entre modelo, runtime, infraestructura y endpoint expuesto.
Inferencia con modelos scikit-learn, XGBoost y otros formatos soportados.
Flujo completo modelo registrado → almacenamiento → InferenceService → endpoint → consumidor.
`ServingRuntime` como plantilla reutilizable y configurable para ejecutar determinados formatos de modelo.
Diferencia entre `ServingRuntime` namespace-scoped y `ClusterServingRuntime` disponible a nivel de clúster.
`supportedModelFormats`, versiones, `autoSelect` y prioridades de selección.
Selección automática del runtime según formato y protocolo.
Runtimes incluidos para scikit-learn, XGBoost, LightGBM, TensorFlow, MLflow, Paddle y PMML.
NVIDIA Triton para TensorFlow, ONNX, PyTorch, TensorRT y escenarios de inferencia optimizada.
Hugging Face Runtime para tareas Transformers e inferencia generativa.
vLLM como runtime orientado a generación eficiente de LLM.
AutoGluon y soporte de inferencia tabular y temporal dentro del ecosistema actual.
Diferencia entre model server y framework utilizado originalmente para entrenar el modelo.
Creación de un ServingRuntime corporativo propio mediante imagen, command, args, environment y probes.
KServe Python Runtime SDK para implementar servidores compatibles con los protocolos de la plataforma.
Personalización de `preprocess`, `predict` y `postprocess` mediante el SDK.
Estrategia para certificar y mantener runtimes corporativos sin permitir imágenes arbitrarias en producción.
Necesidad de una interfaz estándar entre aplicaciones consumidoras y diferentes servidores de modelos.
KServe V1 Protocol y endpoints tradicionales de prediction y explanation.
Open Inference Protocol V2 como interfaz estandarizada para health, metadata e inference.
HTTP/REST y gRPC como transportes soportados por V2.
Model readiness, server readiness y server liveness.
Metadata de servidor y metadata de modelo.
Version-specific model endpoints.
Representación de inputs, outputs, shapes y datatypes.
Binary Tensor Data Extension para escenarios donde JSON introduce demasiado overhead.
V1 como opción todavía soportada y V2 como protocolo recomendado para nuevas integraciones predictivas.
Limitación actual de V2 respecto al endpoint estandarizado de explicación disponible en V1.
Transformer como componente para preprocesar peticiones y postprocesar respuestas.
Comunicación Transformer → Predictor mediante REST o gRPC V2.
Explainability y separación conceptual entre inferencia y generación de explicaciones.
Separación entre imagen del runtime y artefactos propios del modelo.
Storage Initializer como contenedor de inicialización encargado de recuperar el modelo antes del serving.
Amazon S3 y sistemas compatibles como repositorios de artefactos.
Google Cloud Storage y Azure Blob Storage.
Persistent Volume Claims para modelos gestionados directamente mediante almacenamiento Kubernetes.
HTTP/HTTPS y repositorios Git en escenarios compatibles.
Hugging Face Hub como origen de modelos.
MLflow Model Registry como fuente integrable dentro de determinadas arquitecturas.
`storageUri` frente a `storageUris` para uno o varios conjuntos de artefactos.
Service Accounts, Secrets y credenciales de acceso al almacenamiento.
`ClusterStorageContainer` para personalizar mecanismos de recuperación.
Modelcars para empaquetar artefactos como imágenes OCI y distribuirlos mediante un registry de contenedores.
Versionado inmutable de artefactos evitando referencias ambiguas como `latest` en producción.
Relación entre almacenamiento, tiempo de inicialización, disponibilidad y escalado horizontal.
Problemas de cold start cuando cada nueva réplica debe descargar varios gigabytes de pesos.
Local Model Cache como mecanismo de precarga de modelos sobre almacenamiento local de los nodos.
`LocalModelCache` para modelos disponibles a nivel de clúster.
`LocalModelNamespaceCache` para escenarios que requieren aislamiento entre tenants o namespaces.
`LocalModelNodeGroup` para determinar qué grupos de nodos mantienen determinados modelos.
`LocalModelNode` como representación del estado de caché de cada nodo.
Uso de discos NVMe locales para acelerar inicialización de cargas de gran tamaño.
Descarga previa desde Hugging Face, S3 u otros orígenes.
Autenticación de los jobs encargados de poblar la caché.
Selección del nodo considerando disponibilidad del modelo y capacidad requerida.
Beneficios de la caché cuando varias réplicas reutilizan los mismos pesos.
Diferencia entre model cache, container image cache y KV cache de inferencia LLM.
Políticas de capacidad, precarga y expulsión de modelos.
Alcance actual del add-on LocalModel sobre workloads `InferenceService`.
Flujo de red cliente → Gateway/Ingress → servicio KServe → predictor.
Gateway API como modelo moderno para administrar rutas, listeners y políticas de tráfico.
Diferencia entre acceso interno al clúster y exposición pública del endpoint.
DNS, hostnames y resolución de servicios.
TLS termination y gestión de certificados.
Autenticación y autorización de consumidores de los modelos.
OAuth 2.0 y OpenID Connect mediante gateways o componentes de la plataforma.
Kubernetes Service Accounts para identidad entre workloads.
RBAC para limitar creación, actualización y lectura de recursos KServe.
Namespaces como frontera organizativa inicial entre proyectos o equipos.
NetworkPolicy para restringir comunicaciones internas.
Service Mesh y mTLS cuando la arquitectura requiere identidad y cifrado service-to-service.
SecurityContext, imágenes no privilegiadas y controles de ejecución de los runtimes.
Separación entre autorización para administrar un modelo y autorización para invocar sus predicciones.
Diseño multi-tenant evitando que credenciales, modelos o endpoints de un equipo queden accesibles desde otro.
Diferencia entre escalar réplicas de un servicio y aumentar los recursos asignados a cada réplica.
Horizontal Pod Autoscaler en Standard Mode.
Métricas CPU y memoria como señales básicas de escalado.
KEDA para autoscaling basado en métricas externas o personalizadas en Standard Mode.
Prometheus y OpenTelemetry como fuentes para métricas avanzadas de carga.
Knative Pod Autoscaler para escalado request-driven en Knative Mode.
Scale-to-zero en Knative y limitaciones actuales de esta capacidad para HTTP en Standard Mode.
Requests y limits y su relación con scheduling y calidad de servicio.
GPU mediante recursos extendidos de Kubernetes.
Node selectors, affinity, tolerations y taints para dirigir workloads a nodos especializados.
Dynamic Resource Allocation para escenarios modernos de asignación de aceleradores.
Métricas específicas de LLM como waiting requests y utilización de KV Cache para controlar escalado.
Tiempo de carga del modelo como factor que modifica la estrategia de autoscaling.
Relación entre throughput, concurrencia, latencia, GPU utilization y coste por inferencia.
Dimensionamiento basado en pruebas de carga y objetivos SLO en lugar de valores arbitrarios.
Diferencia entre versión del artefacto, versión del ServingRuntime y revisión del servicio desplegado.
Model Registry como fuente de candidatos aprobados para despliegue.
Promoción entre development, staging y production sin volver a entrenar el mismo modelo.
Estrategia rolling update para cambios de bajo riesgo.
Canary deployment para enviar una parte del tráfico hacia una nueva revisión.
Registro de la última versión saludable para permitir rollback.
Traffic splitting entre versiones según las capacidades del modo de despliegue utilizado.
Soporte actual para estrategias progresivas tanto en servicios predictivos como en las nuevas arquitecturas LLM.
Shadow testing para evaluar un candidato sin utilizar todavía sus resultados.
Champion/Challenger como patrón de comparación de modelos.
Métricas técnicas y métricas predictivas que deben evaluarse antes de promocionar una revisión.
GitOps mediante manifiestos KServe versionados en Git.
Helm, Kustomize y overlays para diferenciar configuraciones entre entornos.
CI/CD para validar YAML, seguridad, imágenes, runtime, endpoints y comportamiento del modelo.
Rollback como operación gobernada y no como modificación manual improvisada.
Necesidad de encadenar varios modelos o servicios para resolver inferencias complejas.
`InferenceGraph` como recurso declarativo para construir grafos distribuidos de inferencia.
Routing de una petición hacia diferentes `InferenceService`.
Secuencias donde la salida de un modelo se convierte en entrada del siguiente.
Pipelines de visión que combinan detección, extracción de características y clasificación.
Pipelines NLP con clasificación, extracción de entidades y otros pasos especializados.
Split para distribuir peticiones entre varios servicios.
Switch para elegir una rama según una condición.
Ensemble para combinar resultados procedentes de varios modelos.
Relación entre InferenceGraph y autoscaling independiente de sus servicios.
Estandarización del protocolo como requisito para facilitar el encadenamiento.
Propagación de errores, timeouts y latencia acumulada en grafos con varios nodos.
Observabilidad end-to-end para conocer qué componente provoca una degradación.
Diferencia entre un grafo de inferencia y un pipeline MLOps de entrenamiento.
Criterios para evitar crear grafos excesivamente acoplados cuando una aplicación orquestadora resulta más apropiada.
Diferencia entre Single Model Serving y Multi Model Serving.
Problema de utilizar un Pod dedicado por cada modelo cuando existen cientos o miles de modelos pequeños.
Consolidación de múltiples modelos sobre un conjunto compartido de runtimes.
`multiModel` en ServingRuntime como indicador de compatibilidad con arquitecturas ModelMesh.
Carga y descarga dinámica de modelos en runtimes compartidos.
Utilización eficiente de memoria y CPU frente al despliegue permanente de todos los modelos.
Densidad de modelos como indicador relevante para plataformas multi-tenant.
Eviction de modelos menos utilizados cuando el runtime necesita liberar capacidad.
Reutilización del model server para diferentes artefactos compatibles.
Separación entre Multi Model Serving y réplicas de un único modelo.
Ventajas para escenarios con modelos personalizados por cliente, región o producto.
Riesgos de noisy neighbor al compartir recursos.
Seguridad y aislamiento cuando múltiples tenants comparten infraestructura.
Cuándo es preferible un InferenceService dedicado por razones de rendimiento, aislamiento o GPU.
Relación entre densidad, latencia de carga, frecuencia de uso y coste total de infraestructura.
Diferencia entre salud del Pod, salud del endpoint y calidad real de la inferencia.
Readiness para impedir tráfico antes de que el modelo esté completamente preparado.
Liveness para detectar procesos que deben ser reiniciados.
Métricas de request rate, latencia, error rate y disponibilidad.
p50, p95 y p99 para analizar distribuciones de latencia.
Throughput, concurrencia y saturación.
Prometheus y Grafana para métricas y dashboards.
OpenTelemetry y tracing distribuido para relacionar gateway, transformer, predictor y servicios externos.
Logs del controlador KServe frente a logs del runtime del modelo.
Kubernetes Events y Conditions como fuentes esenciales para diagnosticar reconciliación.
Problemas habituales: `CrashLoopBackOff`, `ImagePullBackOff`, modelos inaccesibles, OOM y probes fallidos.
Diagnóstico de errores de storage initializer y credenciales de almacenamiento.
Problemas de routing, DNS, Gateway, certificados y autorización.
Load testing para establecer capacidad y detectar degradación antes de producción.
SLI, SLO, alertas y runbooks específicos para servicios de inferencia.
Diferencias operativas entre servir un modelo predictivo pequeño y un Large Language Model.
OpenAI-compatible APIs como interfaz habitual para aplicaciones generativas dentro de KServe.
Hugging Face Serving Runtime para modelos Transformers.
vLLM como motor de inferencia optimizado para LLM.
Continuous batching para mejorar throughput.
Prefix caching para reutilizar computación asociada a prefijos repetidos.
Chunked prefill para procesar prompts extensos de forma más eficiente.
Streaming de tokens y consecuencias sobre networking, timeouts y observabilidad.
Selección de dtype, cuantización y memoria GPU según el modelo.
Tensor Parallelism para distribuir pesos entre varias GPU.
Ejecución multi-GPU y multi-node en modelos que no caben en una única GPU.
OpenAI SDK y otros frameworks como consumidores de endpoints desplegados por KServe.
Modelos privados de Hugging Face y utilización segura de tokens.
Autoescalado con métricas relacionadas con cola de solicitudes y utilización de recursos.
Criterios para utilizar `InferenceService` o evolucionar hacia `LLMInferenceService`.
`LLMInferenceService` como CRD especializado para workloads generativos de gran escala.
Estrategia actual dual: `InferenceService` para predictivo y GenAI estándar y `LLMInferenceService` para capacidades LLM avanzadas.
llm-d como arquitectura Kubernetes-native empleada para scheduling e inferencia LLM distribuida.
Router e InferencePool como componentes separados de routing y ejecución.
Prefix-cache-aware routing para favorecer backends que ya disponen del contexto necesario.
Load-aware scheduling para distribuir tráfico según capacidad real.
LeaderWorkerSet para coordinar workloads LLM multi-node.
Tensor Parallelism, Data Parallelism y Expert Parallelism.
Prefill/Decode Disaggregation para separar procesamiento del prompt y generación de tokens.
KV Cache transfer y KV Cache offloading hacia memoria CPU para ampliar capacidad efectiva.
Modelos Mixture-of-Experts y despliegues distribuidos de gran tamaño.
Traffic splitting entre diferentes `LLMInferenceService` mediante grupos y pesos.
Distributed tracing declarativo mediante OpenTelemetry en componentes de inferencia y scheduler.
Envoy AI Gateway y routing OpenAI-compatible con metering y políticas basadas en tokens.
AgentGateway, telemetría GenAI y rate limiting sensible al consumo de tokens en arquitecturas compatibles.
Arquitectura de una plataforma KServe preparada para modelos predictivos y una carga generativa.
Definición de namespaces, ownership, permisos y responsabilidades entre Data Science, MLOps y Platform Engineering.
Selección razonada entre Standard Mode y Knative Mode.
Configuración de Gateway API, TLS y exposición controlada de endpoints.
InferenceService para un modelo predictivo versionado y almacenado externamente.
ServingRuntime específico y versión fijada para garantizar reproducibilidad.
Protocolo V2 para inferencia, readiness, liveness y metadata.
Transformer para preprocesamiento y postprocesamiento desacoplados del predictor.
Estrategia de almacenamiento mediante cloud storage, PVC, Hugging Face u OCI según cada modelo.
Política de caché y reducción de cold starts para modelos de gran tamaño.
Recursos CPU, memoria y GPU dimensionados según pruebas de carga.
Autoscaling mediante HPA, KEDA o Knative según el patrón seleccionado.
Estrategia Canary, rollback y promoción entre entornos.
InferenceGraph para un workflow que requiere varios servicios de inferencia.
LLM desplegado mediante InferenceService o LLMInferenceService según sus requisitos de escala.
Diseño del routing LLM, KV Cache, paralelismo y uso de GPU.
Observabilidad mediante métricas, logs y trazas distribuidas.
Dashboards y alertas sobre disponibilidad, errores, latencia, throughput y saturación.
Seguridad mediante RBAC, Secrets, Service Accounts, NetworkPolicy y autenticación del endpoint.
Pipeline CI/CD o GitOps para validar y desplegar manifiestos de forma reproducible.
Integración con Model Registry y trazabilidad entre modelo, versión, runtime y servicio desplegado.
Procedimiento de troubleshooting para problemas de storage, runtime, red, GPU y escalado.
Runbook de rollback ante una revisión que no cumple los SLO.
Criterios de coste para CPU, GPU, réplicas, almacenamiento y transferencia.
Documentación de arquitectura, dependencias, configuraciones y decisiones relevantes.
Matriz de riesgos de disponibilidad, seguridad, rendimiento y dependencia tecnológica.
Checklist de readiness antes de habilitar tráfico productivo.
Estrategia de actualización de KServe, runtimes y dependencias de Kubernetes.
Modelo final de operación continua, observabilidad, gobierno y mantenimiento del servicio.
Machine Learning Engineers
Profesionales responsables de transformar modelos entrenados en servicios de inferencia escalables y mantenibles.
MLOps Engineers
Perfiles encargados del ciclo de despliegue, versionado, monitorización, actualización y retirada de modelos.
Platform Engineers
Profesionales que diseñan plataformas Kubernetes reutilizables para equipos de Machine Learning e IA.
DevOps Engineers
Perfiles responsables de CI/CD, networking, seguridad, observabilidad, contenedores y operación de servicios.
Data Scientists
Profesionales que necesitan comprender qué ocurre después del entrenamiento y cómo preparar correctamente sus modelos para producción.
AI Engineers
Perfiles que despliegan Transformers, embeddings, rerankers y Large Language Models dentro de aplicaciones de IA.
Kubernetes Engineers
Profesionales que quieren especializarse en workloads de inferencia y aceleradores sobre Kubernetes.
Cloud Engineers
Perfiles encargados de infraestructura de inferencia en AWS, Azure, Google Cloud, entornos híbridos u on-premises.
Arquitectos MLOps
Profesionales que deciden runtimes, networking, almacenamiento, escalado, seguridad y patrones de deployment.
AI Platform Architects
Perfiles responsables de plataformas compartidas para modelos predictivos y generativos a escala empresarial.
Experiencias reales de equipos que ya han trabajado con nosotros.
+16
años de liderazgo
+3.500
empresas formadas
Nuestra empresa decidió contratar formación con Imagina aprovechando los créditos de FUNDAE, y fue una gran decisión. La modalidad online nos permitió adaptar los horarios a nuestro equipo. La formación ha sido práctica, clara y útil para el día a día. Es sencillo de gestionar y los resultados son excepcionales.

Hugo Gutiérrez
Analista Financiero
Gracias a Imagina, la eficiencia de nuestras sesiones de capacitación ha mejorado drásticamente. Es sencillo de usar y los resultados son excepcionales.
Luis Martínez
Administrativo
Gracias al aula virtual de Imagina siempre son capaces de adaptar los cursos a nuestras necesidades. El contenido fue muy completo y práctico.
Elena Pérez
Responsable de Recursos Humanos
Mejor de lo esperado, la modalidad online se adapta a nuestros horarios. La ayuda con la bonificación FUNDAE hizo todo más fácil. Práctico y necesario.
Alejandro Sánchez
Director de Operaciones
Nuestra empresa decidió contratar formación con Imagina aprovechando los créditos de FUNDAE, y fue una gran decisión. La modalidad online nos permitió adaptar los horarios a nuestro equipo. La formación ha sido práctica, clara y útil para el día a día. Es sencillo de gestionar y los resultados son excepcionales.
Hugo Gutiérrez
Analista Financiero
Gracias a Imagina, la eficiencia de nuestras sesiones de capacitación ha mejorado drásticamente. Es sencillo de usar y los resultados son excepcionales.
Luis Martínez
Administrativo
Gracias al aula virtual de Imagina siempre son capaces de adaptar los cursos a nuestras necesidades. El contenido fue muy completo y práctico.
Elena Pérez
Responsable de Recursos Humanos
Mejor de lo esperado, la modalidad online se adapta a nuestros horarios. La ayuda con la bonificación FUNDAE hizo todo más fácil. Práctico y necesario.
Alejandro Sánchez
Director de Operaciones
480.000 alumnos formados en Imagina
Explora las respuestas a las preguntas que guian a nuestra comunidad. Aqui encontraras claridad sobre como funciona todo, desde el acceso hasta los detalles de los cursos. Si buscas respuestas, este es el lugar para comenzar.
KServe es una plataforma Kubernetes-native para desplegar y operar modelos de Machine Learning e IA generativa mediante recursos especializados, runtimes y mecanismos integrados de escalado y networking.
No necesariamente. KServe pertenece al ecosistema Kubeflow, pero puede instalarse y utilizarse como plataforma de model serving en un clúster Kubernetes sin desplegar toda la distribución de Kubeflow.
InferenceService cubre modelos predictivos y escenarios generativos estándar. LLMInferenceService está diseñado para LLM que requieren routing avanzado, distribución multi-node y optimizaciones específicas.
KServe incluye runtimes para tecnologías como scikit-learn, XGBoost, LightGBM, TensorFlow, Triton, Hugging Face, MLflow y otros formatos, además de runtimes personalizados.
Sí. Open Inference Protocol V2 define interfaces HTTP/REST y gRPC para inference, metadata y health checks.
Sí. Puede utilizarse InferenceService con runtimes como vLLM para escenarios estándar y LLMInferenceService cuando se necesitan capacidades LLM especializadas.
Sí. Standard Mode puede utilizar HPA y KEDA, mientras Knative Mode ofrece su propio modelo de autoscaling request-driven.
Sí. El curso incluye asignación de GPU, scheduling y arquitecturas multi-GPU y multi-node para modelos que necesitan distribuir la inferencia.
Sí. Se cubren métricas, logging, tracing, Prometheus, Grafana, OpenTelemetry, health checks, SLO y troubleshooting.
La formación puede ser bonificable a través de FUNDAE hasta el 100% cuando la empresa dispone de crédito suficiente y se cumplen los requisitos aplicables a la Formación Programada por las Empresas.
¿Tienes dudas?
Estamos aqui para ayudarte
KServe es una plataforma Kubernetes-native para desplegar y operar modelos de Machine Learning e IA generativa mediante recursos especializados, runtimes y mecanismos integrados de escalado y networking.
¿Tienes dudas?
Estamos aqui para ayudarte
No necesariamente. KServe pertenece al ecosistema Kubeflow, pero puede instalarse y utilizarse como plataforma de model serving en un clúster Kubernetes sin desplegar toda la distribución de Kubeflow.
¿Tienes dudas?
Estamos aqui para ayudarte
InferenceService cubre modelos predictivos y escenarios generativos estándar. LLMInferenceService está diseñado para LLM que requieren routing avanzado, distribución multi-node y optimizaciones específicas.
¿Tienes dudas?
Estamos aqui para ayudarte
KServe incluye runtimes para tecnologías como scikit-learn, XGBoost, LightGBM, TensorFlow, Triton, Hugging Face, MLflow y otros formatos, además de runtimes personalizados.
¿Tienes dudas?
Estamos aqui para ayudarte
Sí. Open Inference Protocol V2 define interfaces HTTP/REST y gRPC para inference, metadata y health checks.
¿Tienes dudas?
Estamos aqui para ayudarte
Sí. Puede utilizarse InferenceService con runtimes como vLLM para escenarios estándar y LLMInferenceService cuando se necesitan capacidades LLM especializadas.
¿Tienes dudas?
Estamos aqui para ayudarte
Sí. Standard Mode puede utilizar HPA y KEDA, mientras Knative Mode ofrece su propio modelo de autoscaling request-driven.
¿Tienes dudas?
Estamos aqui para ayudarte
Sí. El curso incluye asignación de GPU, scheduling y arquitecturas multi-GPU y multi-node para modelos que necesitan distribuir la inferencia.
¿Tienes dudas?
Estamos aqui para ayudarte
Sí. Se cubren métricas, logging, tracing, Prometheus, Grafana, OpenTelemetry, health checks, SLO y troubleshooting.
¿Tienes dudas?
Estamos aqui para ayudarte
La formación puede ser bonificable a través de FUNDAE hasta el 100% cuando la empresa dispone de crédito suficiente y se cumplen los requisitos aplicables a la Formación Programada por las Empresas.
¿Tienes dudas?
Estamos aqui para ayudarte
Descubre Que es Microsoft Power Automate o Microsoft Flow: Guía Completa de la Herramienta de Automatización de Tareas de Microsoft
Descubre cómo instalar Kali Linux fácilmente y empieza a usar esta herramienta esencial para pruebas de penetración y análisis forense digital.
Conoce los cursos bonificados para trabajadores 2025 más demandados y cómo puedes inscribir a tus empleados para aprovechar los créditos formativos de FUNDAE.
Conoce los cursos obligatorios para empresas 2025 y cómo asegurar que tu organización cumpla con las normativas actuales sin riesgos de sanciones.
Descubre los mejores cursos bonificados para empresas en 2025 por la Fundación Tripartita. Aumenta la productividad de tu equipo sin costes adicionales.
Cuéntanos tus objetivos de negocio y prepararemos una propuesta formativa bonificable totalmente ad hoc