Trazabilidad end-to-end Permite seguir una interacción desde el usuario hasta modelos, RAG, agentes secundarios, herramientas, aplicaciones e infraestructura.
1
Totalmente práctico y aplicable
Formación en Grafana Agent Observability a medida
100% bonificable a través de FUNDAE
Curso TUTORIZADO por expertos


Curso de Grafana Agent Observability en Aula Virtual Personalizada
Nuestra modalidad AVP es una formación en directo, práctica y 100% adaptada a vuestro equipo. No trabajamos con contenidos genéricos: diseñamos la formación en función de vuestro nivel, objetivos, procesos internos y necesidades reales de aplicación.
Solicitar información
Temario 100% a medida
Creamos el temario desde cero a partir de vuestras necesidades, nivel del equipo y objetivos concretos, priorizando aquellos contenidos que realmente aporten valor en el día a día.
Proyectos personalizados
Durante la formación trabajaremos con archivos, ejemplos, informes o procesos similares a los que utiliza vuestro equipo, para que el aprendizaje sea directamente aplicable al puesto de trabajo.
Sesiones en directo con consultor experto
Un formador especialista imparte las clases en tiempo real, resolviendo dudas, revisando casos concretos y adaptando el ritmo de la formación a la evolución del grupo.
Calendario adaptado a vuestra disponibilidad
Definimos conjuntamente fechas, horarios y duración de las sesiones para facilitar la asistencia del equipo y minimizar el impacto en la operativa diaria de la empresa.
Forma a tu equipo sin costes mediante la bonificación estatal.
Este programa de Grafana Agent Observability para empresas es subvencionable hasta el 100%.
Calcula tu bonificación
Revisamos tu caso
Preparamos la gestión
Tu equipo realiza el curso
Aplicas la bonificación
Todos nuestros cursos son bonificables a través de FUNDAE.
Gestionamos toda la documentación por ti.
Calcula tu crédito aproximado
Crédito bonificable estimado
420€*
*Cálculo orientativo
Diseñamos una formación a medida utilizando los documentos y flujos de trabajo reales de tu empresa.

Los alumnos podrán revisar las sesiones grabadas para repasar conceptos clave, recuperar explicaciones concretas o reforzar aquellos contenidos que necesiten después de la clase en directo.

Materiales, sesiones grabadas y documentación de apoyo quedan centralizados en la plataforma para que el equipo pueda consultarlos durante y después de la formación.

La plataforma permite registrar y confirmar la asistencia de los participantes, facilitando el seguimiento de la formación y la gestión documental necesaria para la bonificación FUNDAE.

Después de la formación en directo, los alumnos podrán acceder a ejercicios prácticos para aplicar lo trabajado en clase y consolidar el aprendizaje con actividades guiadas.
Los alumnos podrán revisar las sesiones grabadas para repasar conceptos clave, recuperar explicaciones concretas o reforzar aquellos contenidos que necesiten después de la clase en directo.
Materiales, sesiones grabadas y documentación de apoyo quedan centralizados en la plataforma para que el equipo pueda consultarlos durante y después de la formación.
La plataforma permite registrar y confirmar la asistencia de los participantes, facilitando el seguimiento de la formación y la gestión documental necesaria para la bonificación FUNDAE.
Después de la formación en directo, los alumnos podrán acceder a ejercicios prácticos para aplicar lo trabajado en clase y consolidar el aprendizaje con actividades guiadas.
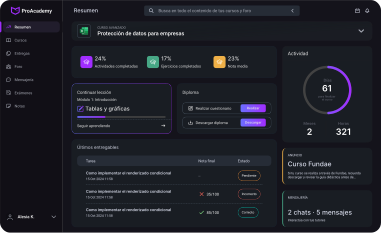
Una plataforma practica, con IA integrada y pensada para que mejores desarrollando. Se adapta a tu ritmo, te corrige al instante y te muestra tu progreso real.
Correccion magica
Feedback inteligente

Aprende de cada acierto y fallo con explicaciones claras
Encuentra todo el temario del curso aquí.

¿Qué es la observabilidad de agentes y por qué las métricas tradicionales de infraestructura no permiten comprender completamente su comportamiento?
Diferencias entre monitoring, observability, LLM observability, AI observability y Agent Observability.
Naturaleza no determinista de los agentes y consecuencias para diagnóstico, reproducibilidad, calidad y operación.
Anatomía de un sistema agéntico: usuario, modelo, instrucciones, memoria, RAG, tools, workflows, agentes secundarios y sistemas externos.
Generaciones, conversaciones, sesiones, tool calls, workflow steps y decisiones como nuevas señales operativas.
Relación entre comportamiento funcional, calidad de respuesta, seguridad, coste y rendimiento.
Diferencia entre detectar que una petición ha fallado y comprender por qué el agente tomó una determinada trayectoria.
Observabilidad desde desarrollo hasta producción como mecanismo de feedback para evolucionar el agente.
Casos de uso: soporte, asistentes internos, agentes de operaciones, automatización, investigación, RAG y sistemas multiagente.
Riesgos específicos: hallucinations, quality drift, loops, tools incorrectas, consumo excesivo, exposición de datos y prompt injection.
Grafana Agent Observability como componente de la suite AI Observability de Grafana Cloud.
Agent Observability alcanzó disponibilidad general el 30 de julio de 2026 y está orientado a agentes LLM ejecutados en producción.
Visión unificada de conversaciones, tool calls, latencia, coste, calidad, métricas, logs, trazas y perfiles dentro de Grafana Cloud.
Construcción de un modelo de confianza que permita observar, evaluar, proteger y mejorar agentes continuamente.
Arquitectura lógica entre agente instrumentado, Agent Observability SDK, generación de telemetría, Grafana Cloud y componentes de análisis.
OpenTelemetry como estándar de instrumentación utilizado para correlacionar agentes con el resto de la plataforma de observabilidad.
Diferencia entre generation data y telemetría OpenTelemetry de métricas y trazas.
Generación como unidad fundamental correspondiente a una llamada realizada por el agente a un modelo de IA.
Captura de modelo, proveedor, mensajes de entrada, respuestas, tool calls, tokens, tiempos, metadata y tags.
Conversaciones como agrupación de múltiples generaciones relacionadas dentro de una interacción completa.
Workflow steps para representar procesamiento que no consiste exclusivamente en llamadas a modelos.
Dependencias entre generaciones para reconstruir flujos ramificados y arquitecturas multiagente.
Spans para correlacionar LLM, aplicación, APIs, herramientas, bases de datos y servicios externos.
Métricas OpenTelemetry de duración, tokens, time to first token y tool calls.
Separación entre exportación de generation data y configuración OTLP para métricas y traces.
Grafana Cloud Metrics, Traces y Logs como fuentes complementarias para comprender el comportamiento técnico de la aplicación.
Profiles como señal adicional cuando se necesita profundizar en consumo y rendimiento del código subyacente.
Correlación entre señales de IA y observabilidad cloud-native para pasar del comportamiento del agente a la causa técnica subyacente.
Diseño de una arquitectura donde la observabilidad forme parte del agente desde su construcción y no se añada únicamente después del despliegue.
Activación de Agent Observability dentro de un stack de Grafana Cloud.
Obtención del generation export endpoint.
Creación y protección de Cloud Access Policy Tokens.
Variables `AGENTO11Y_ENDPOINT`, protocolo, tenant, autenticación y token.
SDK oficial `agento11y` como base actual de instrumentación.
Instrumentación de agentes Python mediante el paquete `agento11y`.
Helpers específicos para OpenAI, Anthropic y Gemini.
SDK disponibles actualmente para Python, TypeScript/JavaScript, Go, Java y .NET.
Requisitos actuales de Python 3.10+ para el SDK correspondiente.
Configuración de exportación HTTP y gRPC.
Batching de generaciones.
Cola interna de exportación.
Flush interval.
Retry automático y exponential backoff.
Límites de payload y comportamiento ante saturación de la cola.
Utilización de client tags para equipo, proyecto, servicio y entorno.
Diferencia entre tags de baja cardinalidad y metadata específica de una generación.
Riesgo de cardinalidad excesiva al convertir identificadores variables en labels de métricas.
Verificación de la llegada de la primera generación a Grafana Cloud.
Configuración adicional de TracerProvider y MeterProvider cuando se quieren exportar métricas y trazas OpenTelemetry.
Migración desde la anterior instrumentación `sigil-sdk` hacia `agento11y` en proyectos existentes.
Instrumentación manual frente a auto-instrumentación mediante integraciones de framework.
Captura automática de generaciones mediante wrappers y callbacks.
Integración con LangChain.
Integración con LangGraph.
Integración con OpenAI Agents.
Integración con LlamaIndex.
Integración con Google ADK.
Integración con Strands Agents.
Integración con Claude Agent SDK.
Integración con Vercel AI SDK.
Integración con LiteLLM y Pydantic AI.
Las integraciones actuales permiten capturar automáticamente generaciones de numerosos frameworks agénticos sin instrumentar individualmente cada llamada.
Instrumentación explícita de llamadas que quedan fuera de las integraciones automáticas.
Seguimiento de retrieval y consultas a Knowledge Bases dentro del flujo completo.
Representación de llamadas a tools, APIs, MCP servers y servicios downstream.
Instrumentación de agentes secundarios dentro de sistemas multiagente.
Propagación de contexto para conservar la trazabilidad entre agentes y componentes.
Inclusión de metadata funcional que permita posteriormente segmentar conversaciones.
Captura de streaming y time to first token.
Coding agents soportados y forwarding de sus sesiones sin incorporar un SDK dentro de la aplicación.
Estrategia de instrumentación progresiva para evitar capturar grandes volúmenes de datos sin una finalidad observacional definida.
Navegación por conversaciones como unidad principal para investigar el comportamiento real del agente.
Búsqueda y filtrado por agente, modelo, versión, estado, tiempo, metadata y otros atributos disponibles.
Reconstrucción completa desde el mensaje inicial hasta la respuesta final.
Análisis individual de cada generación dentro de una conversación.
System prompt, mensajes del usuario, resultados de herramientas y respuestas del modelo.
Tokens de input, output, cache read, cache write y reasoning cuando son reportados por el proveedor.
Duración total y duración de cada llamada.
Time to first token en respuestas streaming.
Tool calls y resultados devueltos.
Workflow steps no asociados directamente a una generación.
Dependencias generation-to-generation.
Visualización de ramificaciones, secuencias y relaciones entre agentes.
Agent graph para comprender recorridos dentro de workflows multi-step y multi-agent.
Trazado de flujos como clasificar → recuperar información → enriquecer → llamar a una herramienta → responder.
Correlación de llamadas a Knowledge Bases con decisiones y respuestas posteriores.
Identificación del punto concreto donde una conversación comienza a desviarse.
Detección de loops, llamadas redundantes y herramientas seleccionadas incorrectamente.
Replay conceptual de las decisiones registradas para investigar cómo se construyó una respuesta.
Comparación entre conversaciones satisfactorias y conversaciones problemáticas.
Uso de conversaciones reales como fuente para crear posteriormente evaluaciones y casos de regresión.
Analytics preconstruido para actividad, rendimiento, uso y coste, herramientas y calidad.
Volumen de generaciones.
Número de conversaciones.
Agentes activos.
Requests y evolución temporal de carga.
Error rate.
Distribuciones de latencia.
p50, p95 y p99 según los objetivos operativos.
Time to first token.
Input tokens.
Output tokens.
Reasoning tokens.
Cache read y cache write tokens.
Coste estimado por agente, modelo y proveedor.
Frecuencia de utilización de tools.
Duración de las tools.
Tool error rate.
Porcentaje de uso de cada herramienta.
Evaluation scores y distribución de puntuaciones.
Tendencias de calidad a lo largo del tiempo.
Correlación entre calidad, latencia y coste para evitar optimizaciones unidimensionales.
Los dashboards incorporados cubren actualmente Activity, Performance, Usage and Cost, Tools y Quality.
Métricas `gen_ai_client_operation_duration_seconds`, `gen_ai_client_token_usage` y métricas específicas de streaming y tools.
Prometheus como base para consultas y dashboards personalizados.
Exemplars para saltar desde un pico de métrica hasta una conversación representativa cuando están habilitados.
Diseño de KPI que distingan salud técnica, eficiencia económica, seguridad y calidad funcional.
Por qué una conversación incorrecta puede tener una causa localizada fuera del modelo.
Correlación entre una generación y su distributed trace.
Seguimiento de una petición desde interfaz o API hasta agente, modelo, tool, database y servicio externo.
Grafana Tempo para análisis de trazas distribuidas.
Grafana Loki para logs de aplicación y servicios relacionados.
Grafana Cloud Metrics para infraestructura, servicios y métricas personalizadas.
Profiles para investigar consumo de CPU y comportamiento interno cuando se necesita mayor profundidad.
Correlation IDs y propagación de trace context.
Relación entre errores de tool calls y fallos de APIs downstream.
Investigación de latencia originada en el modelo frente a latencia producida por retrieval, tools o infraestructura.
Correlación entre calidad degradada y cambios de aplicación o dependencias.
Análisis conjunto de agente y Kubernetes.
Relación con Application Observability.
Investigación de problemas de red, saturación, timeouts y errores de backend que afectan indirectamente a la respuesta del agente.
Logs estructurados para enriquecer el diagnóstico sin depender de texto libre.
Identificación de un error técnico que termina apareciendo al usuario como una respuesta incompleta o incorrecta.
Trazabilidad end-to-end como mecanismo para evitar silos independientes entre AI Engineering, Platform Engineering y SRE.
Grafana Agent Observability permite conectar conversaciones individuales con trazas y métricas de OpenTelemetry dentro del mismo entorno.
Estrategia para pasar desde una señal de calidad hacia la infraestructura responsable de la degradación.
Diferencia entre observación pasiva y evaluación explícita del comportamiento del agente.
Online evaluations sobre tráfico real de producción.
Evaluators como definiciones reutilizables de criterios de calidad.
Rules para determinar sobre qué tráfico debe ejecutarse cada evaluación.
Evaluación por generación.
Evaluación a nivel de conversación.
Evaluadores deterministas frente a evaluadores basados en LLM.
LLM-as-a-Judge.
Configuración de judge providers.
Evaluaciones de relevancia.
Correctness.
Helpfulness.
Groundedness.
Calidad de respuesta.
Cumplimiento de instrucciones.
Evaluación de formato mediante JSON Schema.
Evaluaciones mediante regex.
Heurísticas y reglas deterministas.
Evaluación de PII.
Evaluación de intentos de prompt injection.
Análisis de outputs potencialmente inseguros.
Muestreo para controlar coste de evaluaciones.
Segmentación por agente, versión, modelo, entorno o tipo de tráfico.
Quality score como serie temporal y no únicamente como puntuación aislada.
Alertas cuando el score cae por debajo de un umbral aceptable.
Agent Observability permite aplicar evaluadores continuamente al tráfico real y visualizar la evolución de sus puntuaciones.
Conversión de conversaciones problemáticas detectadas en producción en nuevos casos de validación.
Diferencia entre evaluar después de una generación y bloquear antes de realizar una llamada al modelo.
Guards como comprobaciones síncronas situadas en el request path.
Secuencia request → guard → allow/deny → llamada al LLM.
Reutilización de evaluadores en reglas de guard.
LLM Judge Guards.
Regex Guards.
JSON Schema Guards.
Heuristic Guards.
Bloqueo de prompts maliciosos.
Detección de prompt injection.
Redacción de información sensible.
Detección y filtrado de PII.
Prevención de exposición accidental de credenciales o secretos.
Filtrado de llamadas a herramientas peligrosas.
Tool allowlisting y control de operaciones admitidas.
Validación estructural antes de utilizar información recibida por el agente.
Priorización de reglas cuando existen múltiples guards.
Acciones de bloqueo, filtrado o redacción según el tipo de riesgo.
Diferencia entre seguridad proporcionada por un guard y autorización real del sistema downstream.
Riesgos de considerar un LLM Judge como frontera única de seguridad.
Monitorización de frecuencia de activación y falsos positivos.
Los guards actuales se ejecutan antes de la llamada al modelo y pueden bloquear prompts, redactar información sensible o impedir tool calls peligrosas.
Defense in Depth combinando Agent Observability, autorización, validación, IAM, secretos y controles propios de la aplicación.
Uso de señales de producción para descubrir nuevas categorías de ataques que deben incorporarse a las reglas.
Agent Catalog como inventario operacional de los agentes instrumentados.
Identificación estable de un agente.
`agent_version` como mecanismo para distinguir releases.
Relación entre versión del agente, versión del prompt y conjunto de tools.
Historial de versiones.
Primera y última observación de cada versión.
Modelos utilizados por versión.
Snapshot de tools.
Prompt footprint.
Comparación de coste entre versiones.
Comparación de token usage.
Comparación de error rate.
Comparación de distribuciones de latencia.
Comparación de evaluation scores.
Detección de regresiones después de modificar un system prompt.
Identificación de una versión que reduce coste pero degrada calidad.
Prompt Insights para analizar características de las instrucciones activas.
Agent Score Analysis mediante judge model cuando se configura agent rating.
Model Cards con información de contexto, capacidades y niveles de precio de modelos utilizados.
`effective_version` en escenarios avanzados donde la identidad del catálogo debe desacoplarse de la etiqueta visible.
Versionado como requisito para poder atribuir un cambio de comportamiento a una release concreta.
Comparación production-to-production frente a evaluación controlada previa al despliegue.
Estrategia de rollback basada en evidencia de calidad, rendimiento y coste.
Diferencia entre online evaluation y offline experimentation.
Conversaciones de producción como fuente de casos relevantes.
Saved conversations.
Test suites.
Casos positivos.
Edge cases.
Casos adversariales.
Expected outputs y criterios de evaluación.
Experiments para comparar una modificación antes de promoverla.
Trials como ejecuciones individuales dentro de un experimento.
Asociación entre trial y generación observada.
Final scores.
Evaluación de diferentes system prompts.
Comparación entre modelos.
Comparación de parámetros.
Comparación de nuevas tools.
Evaluación de cambios en RAG.
Detección de regresiones de calidad.
Detección de regresiones de latencia.
Detección de regresiones de coste.
Artefactos asociados a una ejecución.
Test suites versionadas.
Ejecución de experimentos mediante SDK.
Python y Go disponen actualmente de soporte específico para registrar experiments y trials mediante el SDK.
Integración de experiments dentro de pipelines CI/CD.
Quality Gates que impiden promocionar una versión cuando no supera los criterios acordados.
Ciclo producción → conversación problemática → test case → mejora → experimento → nueva versión → producción.
Relación entre agent design y coste de inferencia.
Coste por generación.
Coste por conversación.
Coste por agente.
Coste por versión.
Coste por modelo y proveedor.
Análisis de agentes con consumo de tokens inesperadamente elevado.
System prompts excesivamente largos.
Contexto innecesario.
Outputs demasiado extensos.
Reasoning tokens y utilización de modos de razonamiento cuando no aportan suficiente valor.
Comparación entre modelos costosos y modelos más pequeños para tareas simples.
Prompt caching.
Cache read tokens.
Cache write tokens.
Cache hit ratio.
Organización de contenido estático al comienzo del prompt para favorecer reutilización de caché.
La analítica actual permite estudiar costes, tokens y eficiencia de prompt caching para cada generación.
Tool definitions como parte del coste de contexto.
Herramientas registradas pero nunca utilizadas.
Tool call frequency.
Tool execution duration.
Llamadas redundantes.
Loops agénticos.
Reducción de número de pasos sin deteriorar calidad.
Latencia end-to-end frente a latencia de una única generación.
Time to first token.
Paralelización de tool calls cuando la arquitectura lo permite.
Detección de bottlenecks en retrieval o sistemas downstream.
Definición conjunta de objetivos de calidad, p95, coste y consumo para evitar optimizar una dimensión sacrificando las demás.
Diferencia entre dashboards para análisis y alertas para detección temprana.
Grafana Alerting aplicado a métricas de Agent Observability.
Alertas por aumento de error rate.
Alertas por degradación de p95 o p99.
Alertas por time to first token.
Alertas por consumo de tokens.
Alertas por coste estimado diario.
Alertas por caídas del quality score.
Alertas por tool error rate.
Detección de cambios anómalos después de una release.
SLI técnicos.
SLI de calidad.
SLI económicos.
SLO multidimensionales para agentes.
Error budgets aplicados a fiabilidad del sistema agéntico.
Drill-down desde alerta hacia agente, versión y conversación.
Exemplars para navegar desde una anomalía agregada hasta ejemplos concretos.
Investigación de una respuesta incorrecta mediante conversation trace.
Investigación de loops y tool calls repetitivos.
Investigación de una latencia alta causada por un proveedor o herramienta.
Investigación de costes disparados por cambio de prompt.
Investigación de calidad degradada después de modificar una versión.
Correlación con logs, traces e infraestructura.
Grafana Assistant como apoyo adicional para explorar datos y acelerar investigaciones dentro de Grafana Cloud.
Creación de runbooks específicos para incidentes de agentes.
Rollback de prompt, modelo, tool set o versión según la causa identificada.
Postmortem que incluya comportamiento del agente y no únicamente fallo técnico.
Conversión de la incidencia en reglas, evaluaciones o experimentos que eviten recurrencias.
Diseño de una política de observabilidad específica para aplicaciones de IA.
Determinación de qué conversaciones deben capturarse y con qué nivel de detalle.
Riesgos de almacenar prompts, respuestas, tool results y contenido recuperado.
Clasificación de información antes de incorporarla a generation data.
Redacción y minimización de información sensible.
Pseudonimización de identificadores cuando no es necesario conocer la identidad real.
Metadata útil frente a metadata de alta cardinalidad.
Client tags de baja cardinalidad para equipo, aplicación y entorno.
Retención de información según requisitos operativos y de cumplimiento.
Permisos de Grafana para limitar quién puede inspeccionar conversaciones o configurar evaluaciones y guards.
Gestión segura de Cloud Access Policy Tokens.
Separación entre development, staging y production.
Inventario de agentes observados.
Ownership de cada agente y sus evaluaciones.
Política de versionado.
Estándares mínimos de instrumentación antes de permitir una release.
SLO mínimos que debe publicar cada agente.
Evaluadores obligatorios según la criticidad del caso de uso.
Guards obligatorios para agentes que procesan información sensible o ejecutan acciones.
Sampling de evaluaciones basado en volumen, coste y riesgo.
Adaptive Telemetry y estrategias de optimización de telemetría cuando aumenta significativamente el volumen.
Gobierno de costes de generaciones, evaluaciones, guards y telemetría.
Agent Observability mide por separado generaciones, consumo de evaluaciones/guards basados en LLM y telemetría estándar.
Equilibrio entre investigación forense y minimización de datos.
Revisión periódica de dashboards, alertas, evaluadores y guards para evitar controles obsoletos.
Modelo operativo compartido entre AI Engineering, SRE, Platform, Security y responsables del producto.
Arquitectura de referencia de un agente conversacional desplegado en un entorno productivo.
Definición del agente, finalidad, usuarios, modelos, herramientas, fuente RAG, aplicación e infraestructura relacionada.
Modelo de señales necesario para observar comportamiento, calidad, seguridad, rendimiento y coste.
Instrumentación mediante `agento11y` y estrategia de captura de generaciones.
Integración de la telemetría OpenTelemetry con métricas y trazas de Grafana Cloud.
Modelo de conversaciones y propagación de contexto end-to-end.
Representación de workflow steps, tool calls, retrieval y dependencias entre generaciones.
Identificación de agentes secundarios en una arquitectura multiagente.
Estrategia de tags y metadata evitando cardinalidad innecesaria.
Definición de versión del agente, prompt y conjunto de herramientas.
Dashboard de actividad, errores, latencia, TTFT, tokens, coste, tools y calidad.
Correlación de conversaciones con aplicación, APIs e infraestructura.
Online evaluations para calidad, relevancia, comportamiento y seguridad.
Reglas específicas para detección de PII y prompt injection.
Guards para bloquear, filtrar o redactar entradas antes de la invocación del modelo.
Política de protección de tool calls de especial impacto.
Catálogo de versiones y criterios de comparación entre releases.
Test suite derivada de conversaciones representativas de producción.
Experimentos para comparar una nueva versión de prompt o modelo.
Quality Gates para evitar desplegar cambios con regresiones significativas.
Estrategia de optimización de tokens y prompt caching.
Identificación de tools innecesarias o excesivamente costosas.
Definición de SLI de disponibilidad, errores, latencia, calidad y coste.
Definición de SLO para el agente.
Alertas de error rate, latencia, coste y degradación de evaluation scores.
Flujo de diagnóstico desde una alerta hasta la conversación y el trace relacionado.
Runbook ante degradación de calidad.
Runbook ante subida anómala de costes.
Runbook ante prompt injection o exposición de información.
Estrategia de rollback hacia una versión anterior.
Política de permisos y acceso a conversaciones.
Política de retención y minimización de datos.
Estimación del consumo derivado de generaciones, evaluaciones, guards y telemetría.
Modelo de ownership entre desarrollo del agente, plataforma, SRE y seguridad.
Ciclo de mejora basado en telemetría de producción, evaluaciones, experimentos y nuevas versiones.
Criterios finales de confianza necesarios para considerar el agente preparado para operar de forma continuada en producción.
AI Engineers
Profesionales que desarrollan agentes, asistentes y aplicaciones generativas y necesitan comprender su comportamiento real en producción.
Generative AI Engineers
Perfiles responsables de prompts, tool calling, RAG, modelos y workflows agénticos.
LLMOps Engineers
Profesionales encargados del ciclo de vida, evaluación, observabilidad y evolución de aplicaciones basadas en LLM.
MLOps Engineers
Perfiles que amplían sus responsabilidades desde modelos predictivos hacia sistemas generativos y agentes.
Site Reliability Engineers
Profesionales responsables de disponibilidad, SLO, alerting, troubleshooting e Incident Response.
Platform Engineers
Equipos que construyen plataformas comunes para desarrollar y operar agentes dentro de la organización.
DevOps Engineers
Profesionales que integran instrumentación, despliegues, alertas y Quality Gates dentro de CI/CD.
Observability Engineers
Especialistas que necesitan incorporar conversaciones, calidad, tokens y costes a las señales tradicionales de observabilidad.
AI Security Engineers
Perfiles responsables de prompt injection, exposición de datos, tools, controles preventivos y respuesta ante comportamientos inseguros.
Backend Developers
Desarrolladores responsables de integrar agentes con APIs, bases de datos, herramientas y servicios downstream.
Arquitectos Cloud y de IA
Profesionales que necesitan definir patrones de observabilidad y gobierno aplicables a múltiples aplicaciones agénticas.
Responsables técnicos de plataformas de IA
Perfiles encargados de establecer estándares de instrumentación, evaluación, seguridad, costes y operación.
Experiencias reales de equipos que ya han trabajado con nosotros.
+16
años de liderazgo
+3.500
empresas formadas
Nuestra empresa decidió contratar formación con Imagina aprovechando los créditos de FUNDAE, y fue una gran decisión. La modalidad online nos permitió adaptar los horarios a nuestro equipo. La formación ha sido práctica, clara y útil para el día a día. Es sencillo de gestionar y los resultados son excepcionales.

Hugo Gutiérrez
Analista Financiero
Gracias a Imagina, la eficiencia de nuestras sesiones de capacitación ha mejorado drásticamente. Es sencillo de usar y los resultados son excepcionales.
Luis Martínez
Administrativo
Gracias al aula virtual de Imagina siempre son capaces de adaptar los cursos a nuestras necesidades. El contenido fue muy completo y práctico.
Elena Pérez
Responsable de Recursos Humanos
Mejor de lo esperado, la modalidad online se adapta a nuestros horarios. La ayuda con la bonificación FUNDAE hizo todo más fácil. Práctico y necesario.
Alejandro Sánchez
Director de Operaciones
Nuestra empresa decidió contratar formación con Imagina aprovechando los créditos de FUNDAE, y fue una gran decisión. La modalidad online nos permitió adaptar los horarios a nuestro equipo. La formación ha sido práctica, clara y útil para el día a día. Es sencillo de gestionar y los resultados son excepcionales.
Hugo Gutiérrez
Analista Financiero
Gracias a Imagina, la eficiencia de nuestras sesiones de capacitación ha mejorado drásticamente. Es sencillo de usar y los resultados son excepcionales.
Luis Martínez
Administrativo
Gracias al aula virtual de Imagina siempre son capaces de adaptar los cursos a nuestras necesidades. El contenido fue muy completo y práctico.
Elena Pérez
Responsable de Recursos Humanos
Mejor de lo esperado, la modalidad online se adapta a nuestros horarios. La ayuda con la bonificación FUNDAE hizo todo más fácil. Práctico y necesario.
Alejandro Sánchez
Director de Operaciones
480.000 alumnos formados en Imagina
Explora las respuestas a las preguntas que guian a nuestra comunidad. Aqui encontraras claridad sobre como funciona todo, desde el acceso hasta los detalles de los cursos. Si buscas respuestas, este es el lugar para comenzar.
Es la solución de Grafana Cloud para observar agentes LLM en producción mediante conversaciones, generaciones, trazas, costes, calidad, herramientas, evaluaciones y otras señales.
No. Agent Observability alcanzó disponibilidad general el 30 de julio de 2026.
Grafana ofrece actualmente SDK para Python, TypeScript/JavaScript, Go, Java y .NET.
Sí. Existen integraciones para LangChain y LangGraph, además de OpenAI Agents, LlamaIndex, Google ADK, Strands Agents, Claude Agent SDK, LiteLLM, Pydantic AI y otros frameworks.
Sí. Se registran tokens, costes estimados y datos de caché por generación, permitiendo analizar tendencias por agente, modelo, proveedor y versión.
Sí. Puede incorporarse tanto a evaluaciones como a guards. Estos últimos permiten realizar comprobaciones síncronas antes de enviar una solicitud al modelo.
Sí. Las online evaluations permiten puntuar continuamente la calidad del tráfico real mediante evaluadores deterministas o basados en LLM.
Sí. Agent Observability está construido sobre OpenTelemetry y permite relacionar generaciones y conversaciones con métricas y distributed traces del resto de la aplicación.
Sí. Agent Catalog registra versiones y permite comparar costes, tokens, errores, latencia y puntuaciones de evaluación, además de analizar cambios en prompts y herramientas.
Sí. La formación puede ser bonificable a través de FUNDAE hasta el 100% cuando la empresa dispone de crédito formativo suficiente y se cumplen los requisitos aplicables a la Formación Programada por las Empresas.
¿Tienes dudas?
Estamos aqui para ayudarte
Es la solución de Grafana Cloud para observar agentes LLM en producción mediante conversaciones, generaciones, trazas, costes, calidad, herramientas, evaluaciones y otras señales.
¿Tienes dudas?
Estamos aqui para ayudarte
No. Agent Observability alcanzó disponibilidad general el 30 de julio de 2026.
¿Tienes dudas?
Estamos aqui para ayudarte
Grafana ofrece actualmente SDK para Python, TypeScript/JavaScript, Go, Java y .NET.
¿Tienes dudas?
Estamos aqui para ayudarte
Sí. Existen integraciones para LangChain y LangGraph, además de OpenAI Agents, LlamaIndex, Google ADK, Strands Agents, Claude Agent SDK, LiteLLM, Pydantic AI y otros frameworks.
¿Tienes dudas?
Estamos aqui para ayudarte
Sí. Se registran tokens, costes estimados y datos de caché por generación, permitiendo analizar tendencias por agente, modelo, proveedor y versión.
¿Tienes dudas?
Estamos aqui para ayudarte
Sí. Puede incorporarse tanto a evaluaciones como a guards. Estos últimos permiten realizar comprobaciones síncronas antes de enviar una solicitud al modelo.
¿Tienes dudas?
Estamos aqui para ayudarte
Sí. Las online evaluations permiten puntuar continuamente la calidad del tráfico real mediante evaluadores deterministas o basados en LLM.
¿Tienes dudas?
Estamos aqui para ayudarte
Sí. Agent Observability está construido sobre OpenTelemetry y permite relacionar generaciones y conversaciones con métricas y distributed traces del resto de la aplicación.
¿Tienes dudas?
Estamos aqui para ayudarte
Sí. Agent Catalog registra versiones y permite comparar costes, tokens, errores, latencia y puntuaciones de evaluación, además de analizar cambios en prompts y herramientas.
¿Tienes dudas?
Estamos aqui para ayudarte
Sí. La formación puede ser bonificable a través de FUNDAE hasta el 100% cuando la empresa dispone de crédito formativo suficiente y se cumplen los requisitos aplicables a la Formación Programada por las Empresas.
¿Tienes dudas?
Estamos aqui para ayudarte
Descubre Que es Microsoft Power Automate o Microsoft Flow: Guía Completa de la Herramienta de Automatización de Tareas de Microsoft
Descubre cómo instalar Kali Linux fácilmente y empieza a usar esta herramienta esencial para pruebas de penetración y análisis forense digital.
Conoce los cursos bonificados para trabajadores 2025 más demandados y cómo puedes inscribir a tus empleados para aprovechar los créditos formativos de FUNDAE.
Conoce los cursos obligatorios para empresas 2025 y cómo asegurar que tu organización cumpla con las normativas actuales sin riesgos de sanciones.
Descubre los mejores cursos bonificados para empresas en 2025 por la Fundación Tripartita. Aumenta la productividad de tu equipo sin costes adicionales.
Cuéntanos tus objetivos de negocio y prepararemos una propuesta formativa bonificable totalmente ad hoc